Hello,未来,「AI教育解决方案」重磅来袭!
详情
AI 古籍文献智能识别修复系统:与时间赛跑,让千年典籍"数字重生"
"古籍动用一次,折寿六十年。"这是古籍保护从业者之间的经验之谈。一边是超过半数古籍存在酸化、虫蛀、脆化、破损等病害,全国仍有 1000 多万册古籍尚未得到有效保护;另一边是修复师从 2007 年的不足百人发展到如今的千余人——而培养一名成熟的修复师,需要近 20 年。抢救的速度,远远赶不上老化的速度。AI 古籍文献智能识别修复系统的意义正在于此:它不替代修复师的双手,却能让"化身千百"的再生性保护跑赢时间。
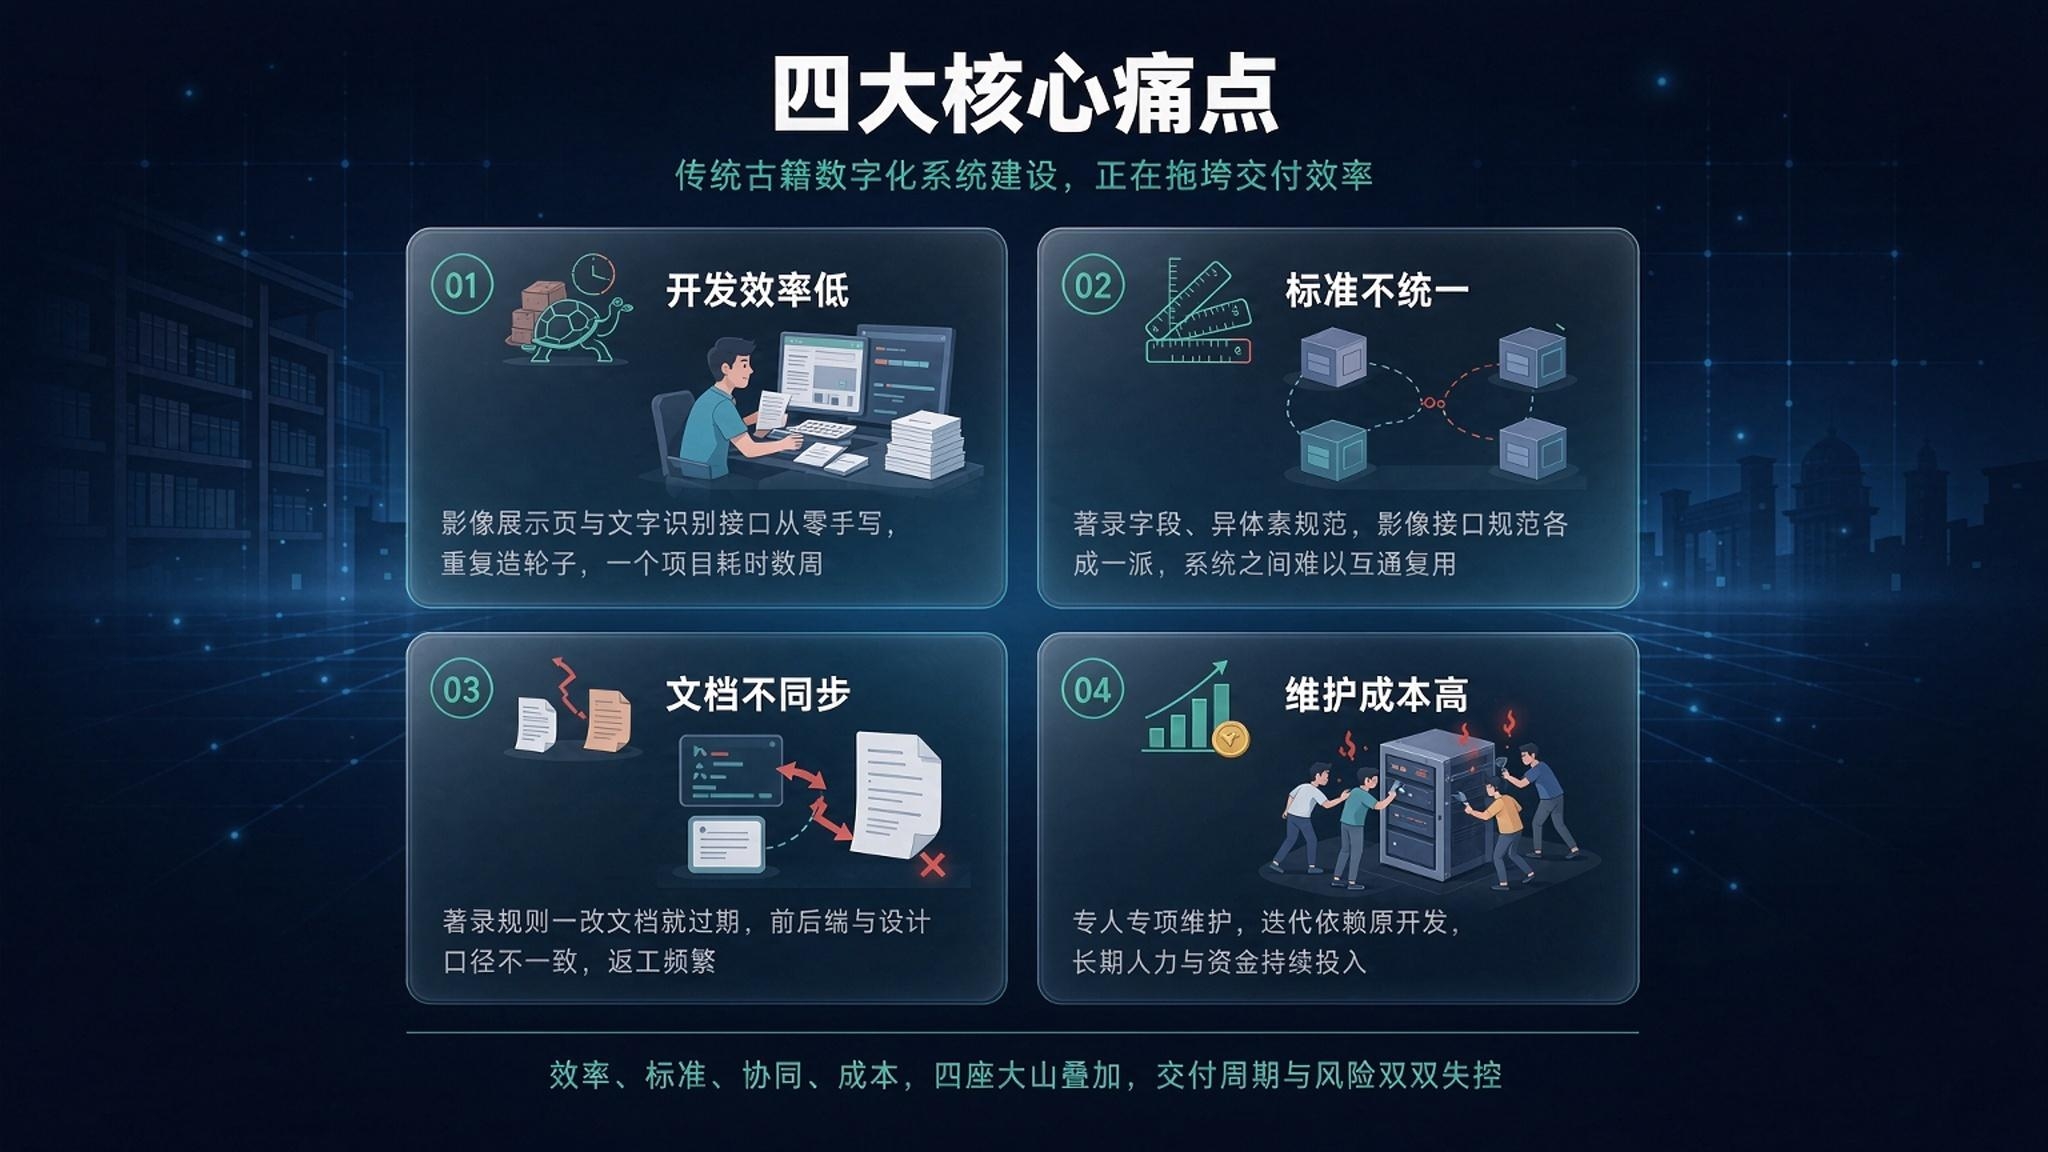
一、传统古籍数字化与修复的五大核心痛点
人才缺口巨大,修复"蚂蚁搬山"。 辽宁省图书馆馆藏古籍 61 万余册,实际参与修复的人员仅 8 人;一个熟练修复师一年最多修 100 册,15 万册未整理古籍全部修完需要百余年。广西全区具备成熟实操能力的修复人才仅 33 人,精通古壮字、能独立完成释读译注的复合型人才不足 30 人。
通用 OCR 在古籍面前几乎失效。 通用 OCR 工具在古籍场景下的准确率往往不足 70%。根本原因在于字符集本身就不同:《康熙字典》收录四万余汉字,大量字在现代字库里没有对应 Unicode 编码;再加上雕版刻工手刻导致的字形变形、避讳字与通假字,识别难度远超一般"图片质量不好"。
版面结构复杂,阅读顺序易乱。 古籍竖排、从右向左读,还有双行夹注、眉批、行间批注、鱼尾、版心、藏书章、后加题记。传统工具常出现"单字识别正确、阅读顺序颠倒错乱不可复用"的情况。
图像质量退化严重。 纸张泛黄酸化、虫蛀孔洞、水渍霉斑、墨迹洇染、碳化区域导致字符断裂——敦煌遗书部分卷册的碳化区域字符断裂率达 30%,传统二值化处理会直接丢失关键笔画特征。
人工录入效率低下,难以规模化。 人工识别单页明代善本需 15 分钟以上,错误率 3%~5%。若完全依靠人力完成全部古籍数字化,可能需要上百年时间。
二、系统核心功能
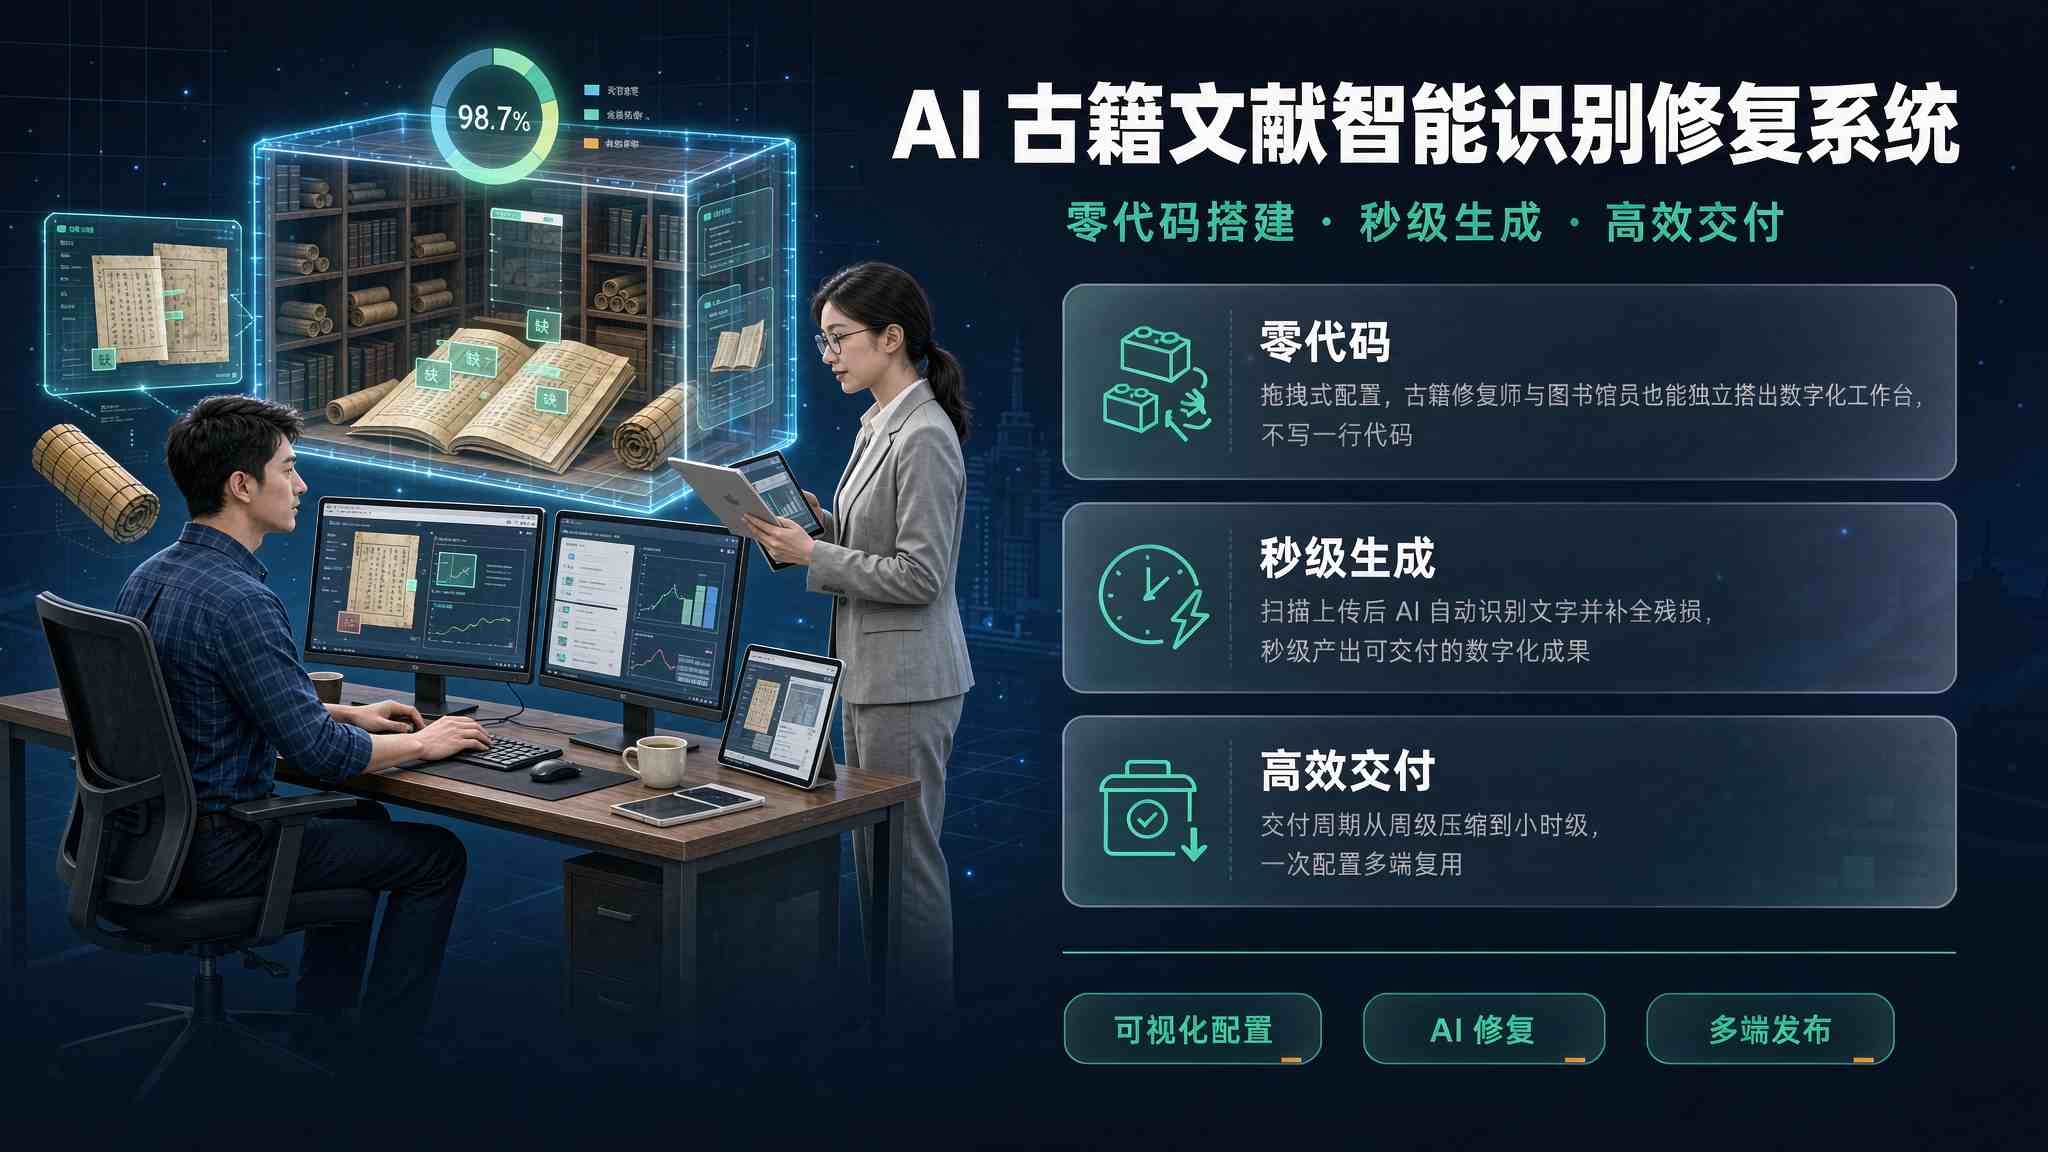
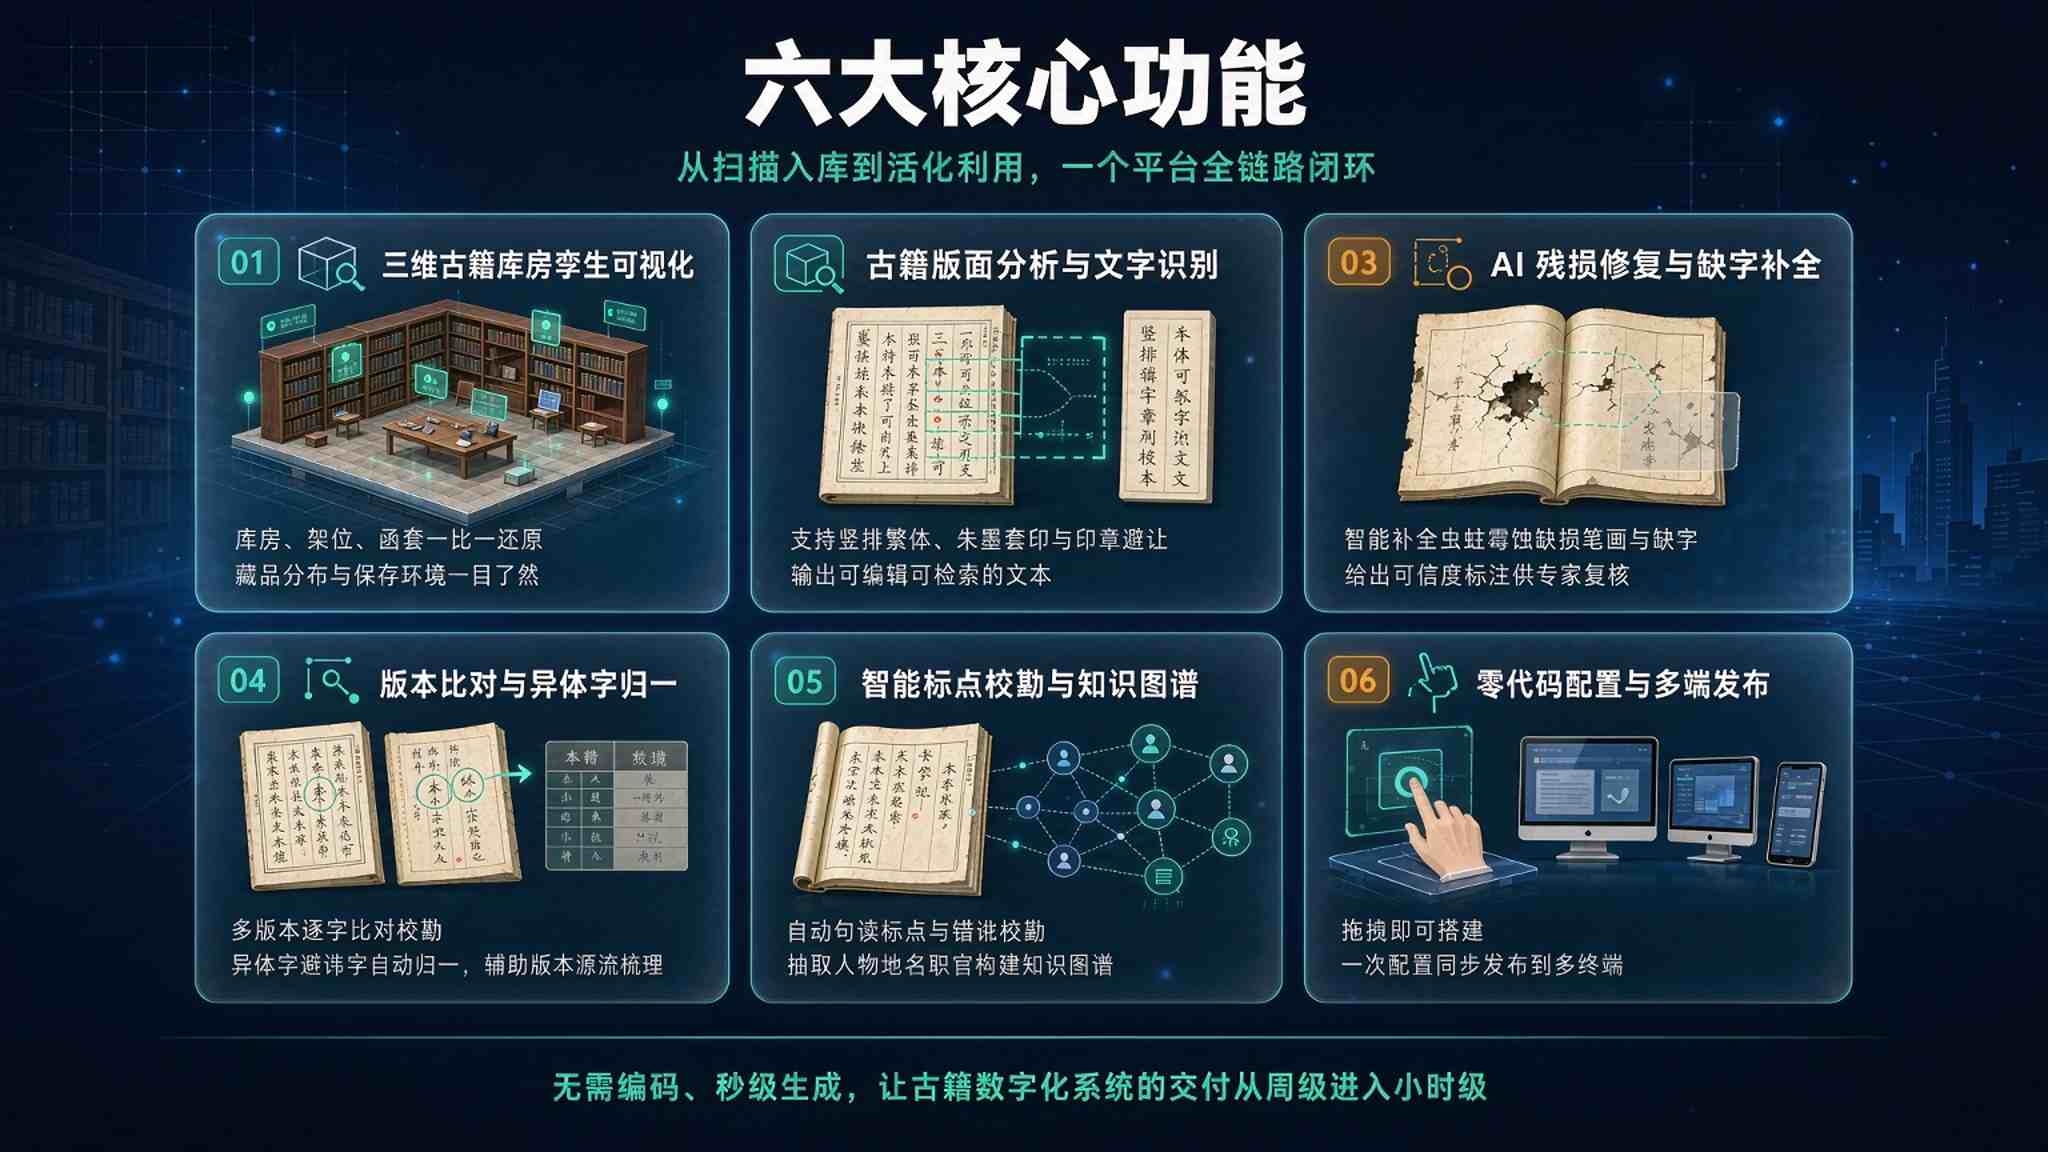
1. 复杂版面智能解析。 基于 Cascade R-CNN、Transformer 布局分析等模型,自动识别正文、双行夹注、眉批、行间批注、表格、版心、印章等区域并分层保存,正确还原从右向左、自上而下的阅读顺序。针对批注层级的识别 F1 值可达 0.92。
2. 古籍专用文字识别。 采用 CNN + ViT 混合架构、CRNN 等模型,配合无监督单字聚类与小样本学习,覆盖繁体、异体字、避讳字、俗字与手写连笔。支持自定义字库扩展,也可将无编码的罕见字以图片形式嵌入,保留原始字形。
3. 图像增强与虚拟修复。 通过非局部均值去噪、Sauvola 局部自适应二值化、超分辨率重建与生成对抗网络(GAN),对模糊、洇染、虫蛀、断裂笔画进行数字修复。配合多光谱成像,可用红外光穿透纸张纤维提取底层字迹。国家图书馆还利用色彩还原与增强算法,为缩微胶片上的黑白影像"上色",还原古籍原始色彩信息;针对敦煌遗书损坏区域的 AI 修复模型,可对字体内容与风格进行高度还原。
4. 自动断句标点与专名标注。 自动标点断句准确率平均达 98.46%,标点准确率 93.94%,专名线、书名线自动标注准确率 92.15%,大幅降低古籍阅读门槛。
5. 人机协同校对平台。 以"左图右文"的版式校对界面呈现识别结果,支持折校、语义纠错、异体字检查、繁简转换与 Unicode 映射;支持众包校对与大规模团队协作。
6. 知识图谱与智能服务。 在完成文本化后进一步做细颗粒度信息抽取,自动关联历史人物、典章制度、地理沿革,构建"可阅读的文物"式交互体验,推动古籍从"藏"到"用"。
三、典型应用场景
图书馆与博物馆馆藏数字化:批量完成馆藏古籍的扫描、识别、校对与发布,建立全文索引与双层 PDF 电子书。
敦煌遗书、碑刻拓片、简牍帛书等特殊文献:对残损区域做内容补全与风格还原,提升数字化完整性。
民族古籍与古文字保护:古壮字、西夏文、满文、梵文夹注等混合文本的识别与释读译注。
大型整理出版工程:如百衲本《二十四史》近 4000 万字,北大整理团队借助 AI 仅用 3 个多月即完成识别、点校、上线发布。
高校数字人文研究:支撑 400 人团队协同作业,一年完成 1.2 亿字的采集与校对。
文化普及与公众服务:数字化后的孤本可被任何人全文检索,让原本只有少数专家能接触的文献走向大众。
四、五大核心优势
一是效率呈数量级跃升。 5 分钟的 OCR 识别相当于人工录入 20 小时的工作量,且错误可降低 75%。海南、银川等地图书馆借助 AI 完成了馆藏典籍的全文数字化。
二是准确率已达实用门槛。 达摩院与四川大学联合开发的系统对首批 20 万页古籍识别准确率达 97.5%;版刻本识别准确率可达 98% 以上,手写体约 95%;基于多模态视觉大模型的古籍图像理解正确率达 97.32%,显著高于传统商用 OCR 的 95.10%。
三是保留原始信息完整。 折痕、虫蛀等历史痕迹以矢量数据完整保留;印章、批注、版心分层存储,不丢失版本学信息。
四是破解"藏用矛盾"。 数字化让古籍"化身千百"——国家图书馆已牵头举办 11 次古籍数字资源联合发布,全国累计发布古籍及特藏影像资源超 16.1 万部/件,2025 年更联合全国 180 余家单位建成"中华古籍智慧化服务平台"。
五是降低基层门槛。 轻量化模型与零代码训练平台让市县级收藏单位、高校也能开展本地化古籍智能识别,缓解区域发展失衡。
五、总结
必须清醒地看到:97% 甚至 99% 的识别率,离"直接出版"仍有距离——按此错误率估算,一万字仍对应数百次编辑操作,而涉及人名、地名、年号与否定词时,一个字就足以改变文献含义。生成式模型还存在"输出很顺却没有忠实对应底本"的风险,可能根据语言习惯自动补齐原图中模糊的内容。因此稳妥的工作流应当把 AI 放在中间而非终点:先保存原始图像与稳定页码,再识别版面与阅读顺序,生成忠实转录,处理繁简异体与 Unicode 映射,最后由人工校勘并保留版本记录。
对文博机构而言,落地时建议"先影像后文本、先常见后特殊":优先完成破损严重、濒危孤本的高清影像采集,让抢救性记录跑在老化前面;再选择版刻清晰、字形规范的古籍做批量识别,积累校对经验后逐步攻坚手写本、拓片与民族古籍。技术的终极目的,不是让机器读懂古文,而是让中华文明第一次有可能实现文化典籍的永久保护与传承。