Hello,未来,「AI教育解决方案」重磅来袭!
详情
AI 专利智能检索分析系统:从"关键词碰运气"到"语义问技术"
一、AI 专利智能检索分析系统是什么
它是一套基于大语言模型、语义理解与专利知识图谱构建的知识产权情报平台。系统把全球上亿件专利文献(说明书、权利要求、引证、同族、法律状态)与科技文献统一接入,通过向量化索引实现语义级检索,再由大模型完成技术特征提取、多维统计、价值评估与报告自动生成。
它区别于传统专利数据库的关键在于:传统库靠布尔逻辑(关键词+分类号)做字面匹配,你得先猜对别人用了什么词;而 AI 系统把检索从"输入关键词找专利"升级为"用自然语言描述技术问题、系统按语义找答案"——同一发明被不同术语、不同语言表达,也能被找出来。
二、传统专利检索分析的五大核心痛点
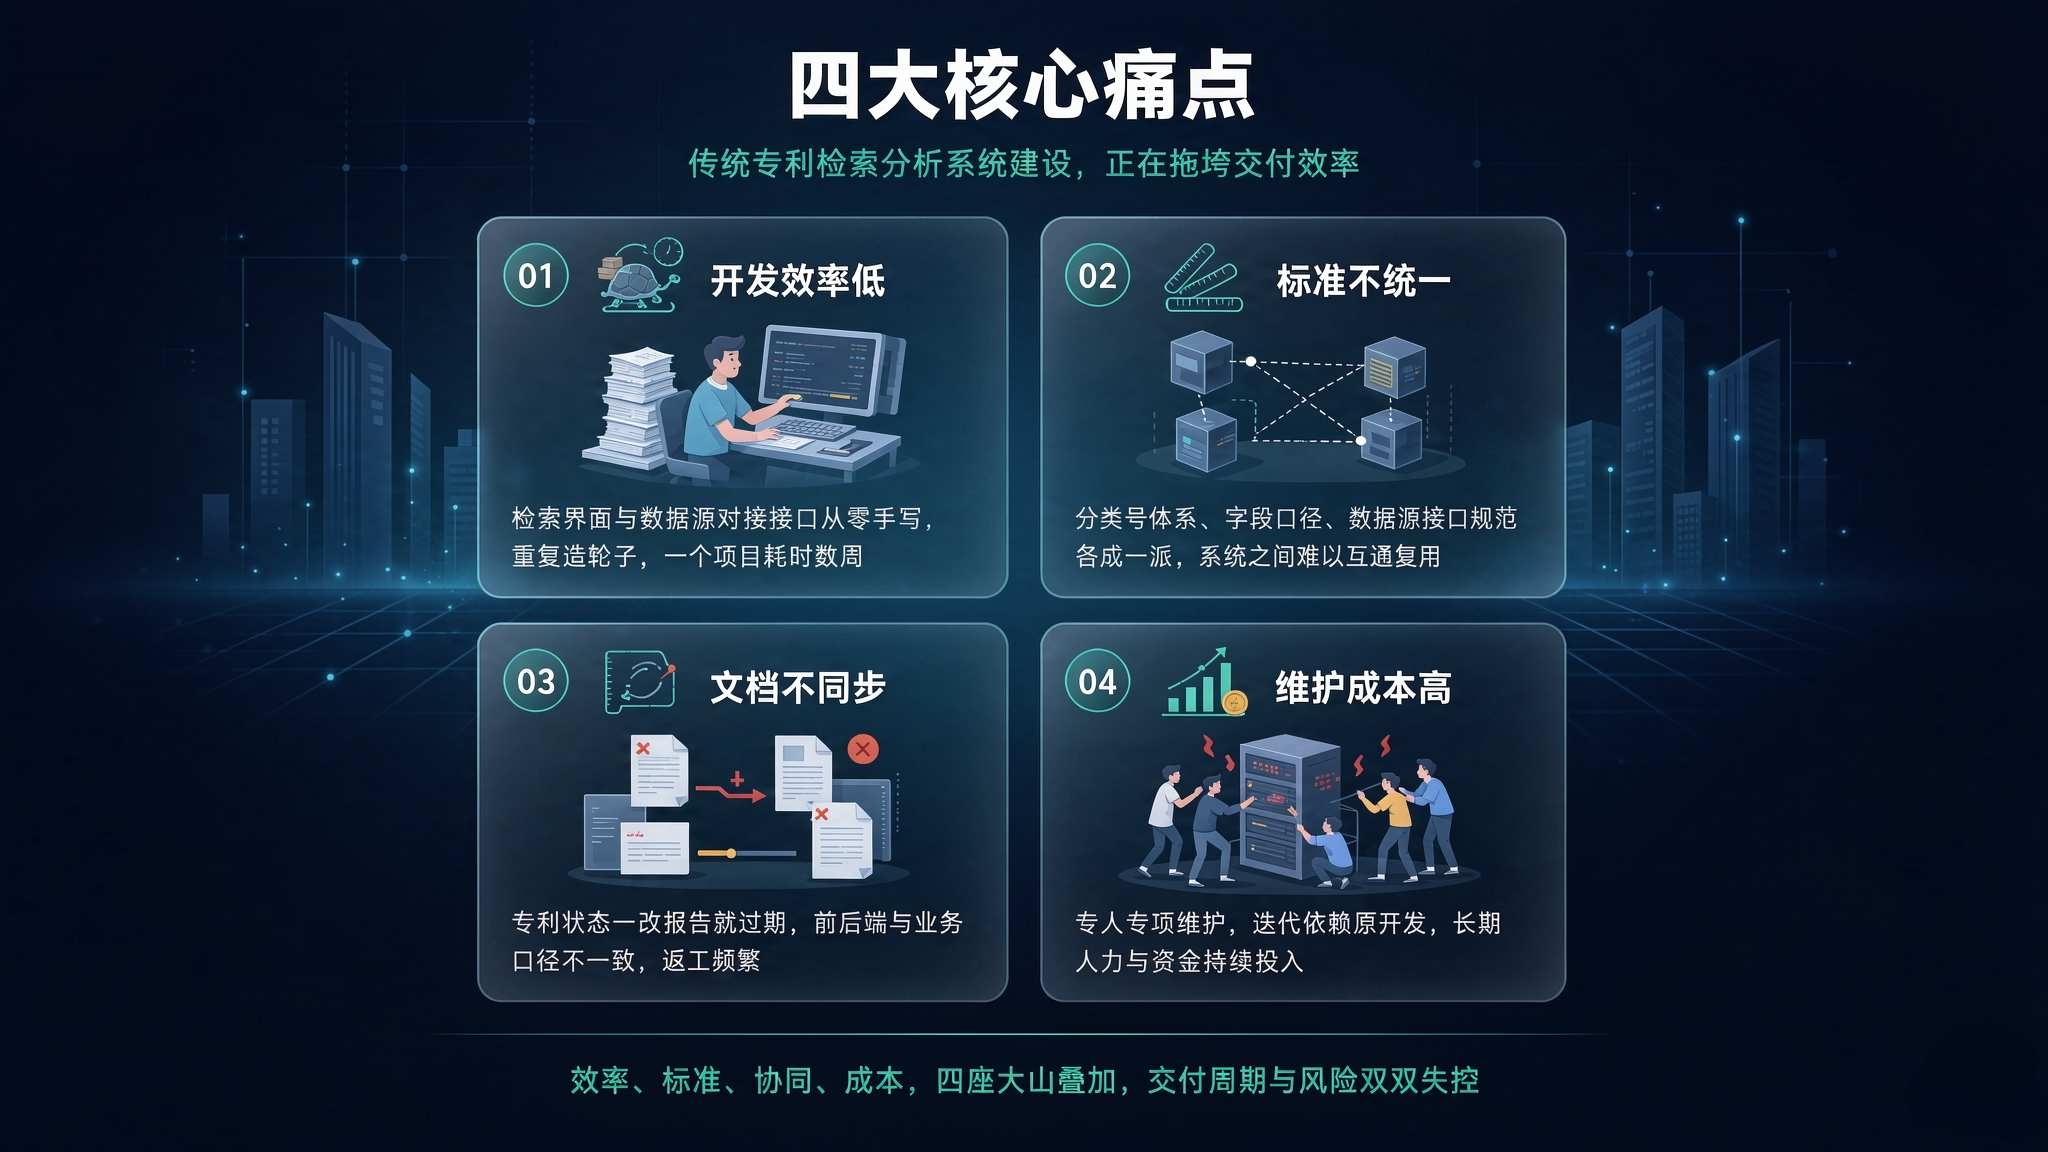
关键词检索漏检严重。 同一技术在不同专利里表述千差万别。有检索者做"无人艇"主题检索,用"无人+船/艇"组合反复调整,最后通过企业验证才发现,很多人把无人艇定义为"水上机器人"——这类漏检几乎无法靠经验穷尽。
噪声多,去噪全靠人工。 一个关键词常被多个领域共用。检索"流变+注射",会涌入大量医学专利;分类号也存在分类不准、副分类、版本更新未同步等噪声。去噪只能靠反复调整检索式,一个检索式常常要经过十几次甚至几十次调整。
查全与查准难以兼顾。 放宽条件召回多但噪音多,收紧条件噪音少但漏检多。行业通用标准是中文文献查全率 90% 以上、查准率 95% 左右,外文查全率 80%、查准率 80%~85%——达到这条线,靠的是资深分析师数周的人工循环。
分析周期长,报告靠手搓。 一份 FTO(自由实施)分析报告标准交付周期 4~8 周;一份产业专利导航报告要经过数据采集、专利地图制作、图表解读、报告撰写、统稿等多道工序,从立项到交付往往以月计。
门槛高,依赖少数专家。 检索要素如何分解、分类号如何选、样本库如何构建验证,都需要长期经验积累。结果是专利情报工作集中在少数资深分析师手中,研发人员想自己查也查不明白。
三、系统核心功能
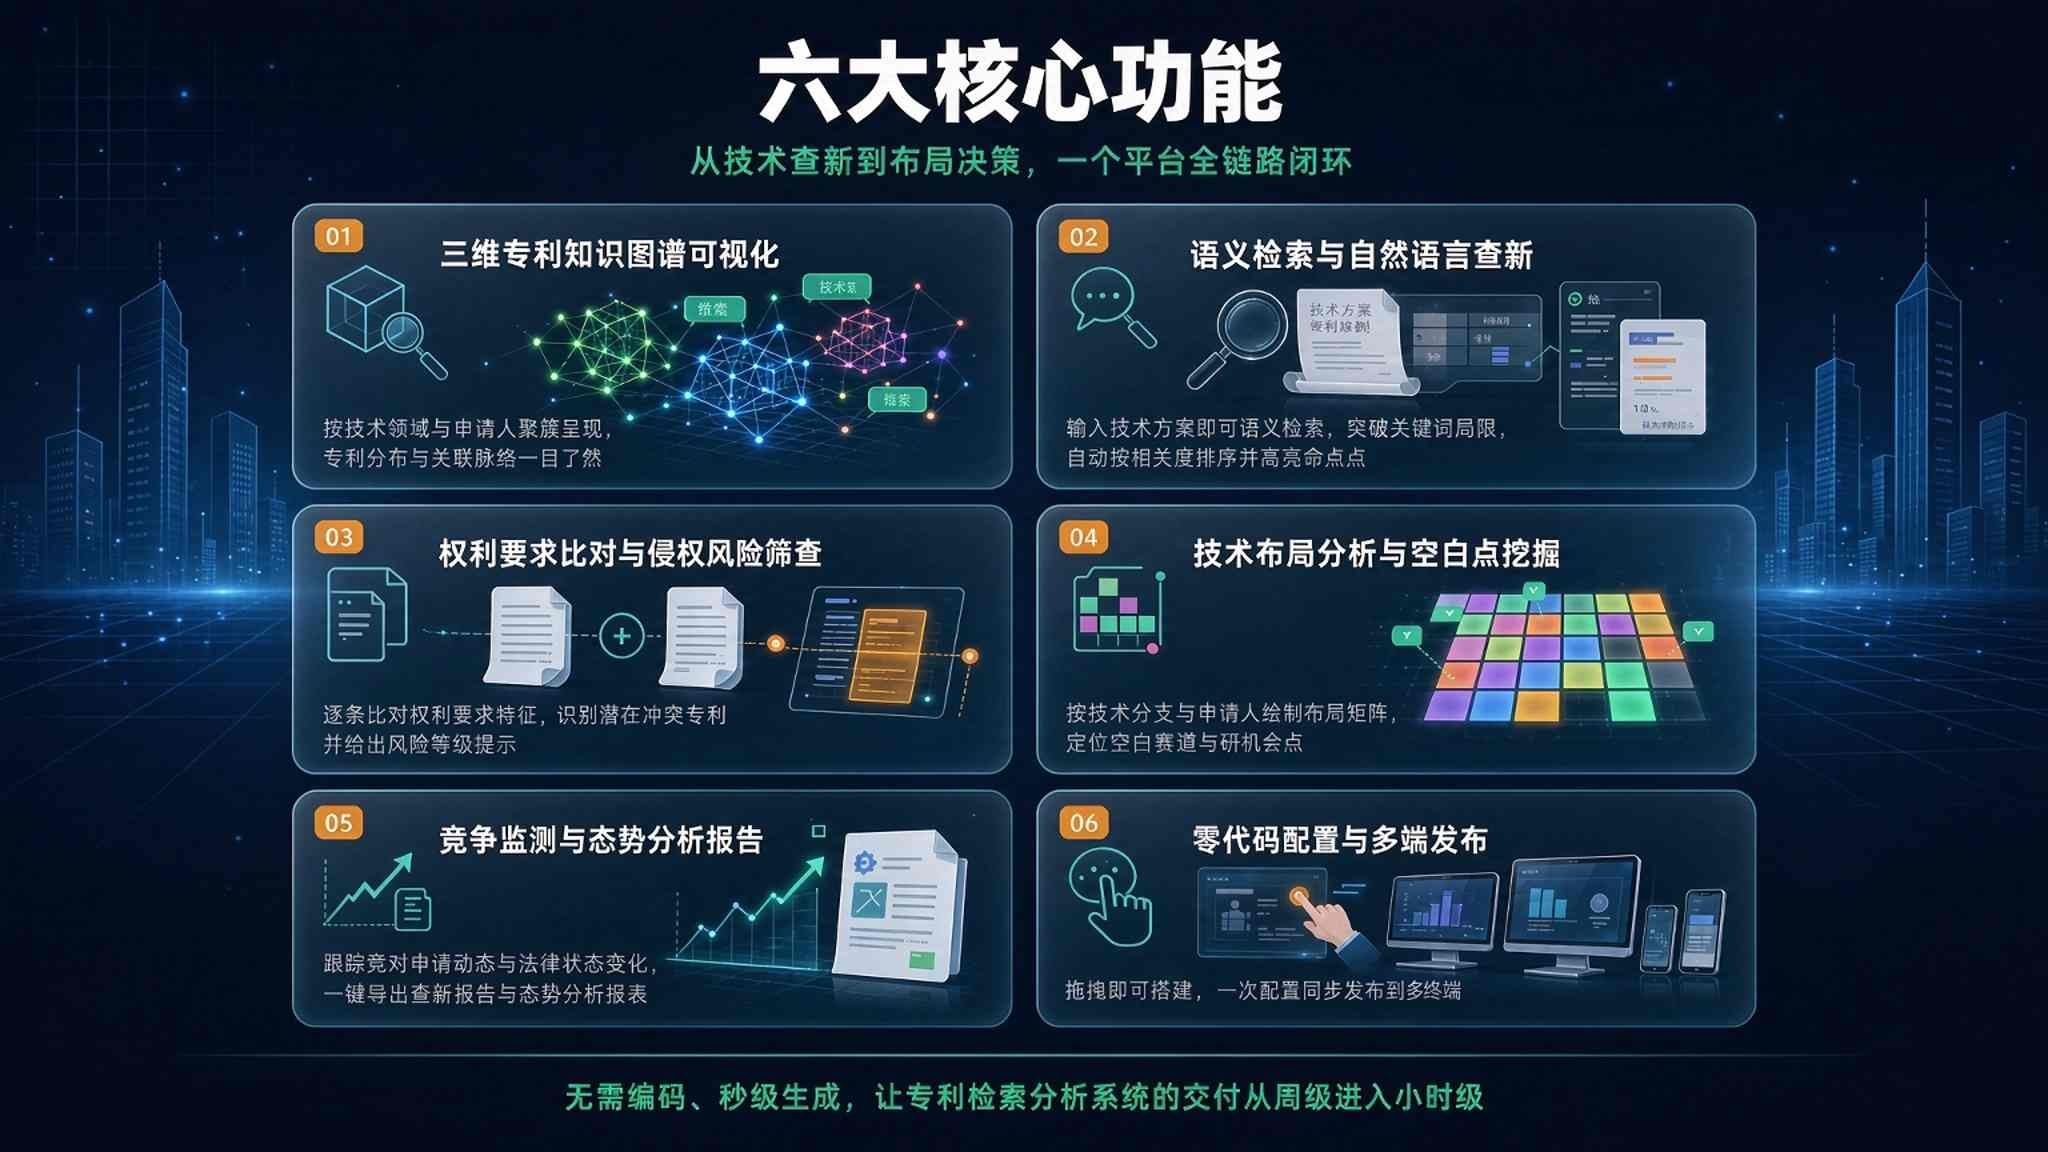
1. 语义检索与多语种跨库检索。 用自然语言描述技术方案即可检索,系统自动扩展同义词、相关概念与跨语言表达,突破"用词不同就找不到"的困局。支持关键词、分类号、语义、引证、同族多路并行召回,各路互补而不互相增加噪声。部分平台已实现文本与附图的多模态混合检索——上传一张技术示意图,也能找到相关专利文本。
2. AI 检索式生成与优化。 用对话方式让大模型生成、改写、优化检索式,把资深检索员的经验显性化,大幅降低新手门槛。
3. 技术特征智能提取。 自动解析专利全文,标注核心技术问题、技术手段与功效,生成结构化对比表,让用户无需通读上百页"天书"就能抓住创新要点。
4. 多维可视化分析。 自动统计技术趋势、申请量变化、主要申请人、技术分支分布、地域布局,生成技术路线图、功效矩阵、引证关系图与专利攻防图,支持 300+ 自定义分析维度。
5. 专利价值评估与核心专利筛选。 结合引用次数、同族规模、权利要求稳定性、法律状态等指标智能打分,从海量结果中快速聚焦高价值专利。
6. 查新与侵权预警(FTO)。 研发立项前自动做专利查新,提示高相关专利与潜在冲突;对自有技术点与他人专利做逐特征比对,输出风险等级与规避设计建议。
7. 分析报告一键生成。 自动生成技术综述、竞争对手分析、专利导航等报告,自动配图表与结论,可导出 Word/PPT/PDF 编辑使用。
8. 专题库与持续监控。 建立企业专属专题专利库,对竞争对手新公开专利自动监控、24 小时内完成初筛并推送预警。
四、典型应用场景
研发立项与技术导航:立项前摸清技术全景,识别技术空白点与红海区域,避免无效研发投入。有服务机构反馈可为客户缩短约 15% 的研发探索周期。
FTO 自由实施分析:产品上市、出口、参展前的侵权风险排查。某汽车零部件企业的 FTO 项目检索 1203 件专利、筛选 95 件关联专利、识别 9 件等同风险专利,比企业自行分析效率提高 60%。
出口与跨境风险预警:针对美国 337 调查等高风险场景做选品侵权核查,为出海企业提供预警。
专利申请前评估与查新:模拟审查员判断逻辑,提前发现驳回风险,提高授权率与撰写质量。
竞争对手与技术监控:持续跟踪对手专利动态、发明人流动、专利布局变化。
高价值专利挖掘与运营:为专利许可转让、质押融资、作价入股提供价值评估依据。
产业与区域专利导航:为政府园区绘制产业专利地图,支撑招商引资与产业规划。
五、五大核心优势
一是查得更全,漏检更可控。 语义检索解决"用词不同"导致的漏检,多路召回把查全率托起来,而不再依赖关键词宽严的单一杠杆。
二是效率数量级提升。 传统数天才能完成的查新报告,借助大模型可在一分钟内生成初稿;FTO 分析周期从 1~2 个月缩短至 1 周内;某医疗科技企业的 FTO 周期从 6 周压缩到 5 天(缩短 85%),提前识别出 3 个阻断专利族,避免了超过百万美元的重新设计成本。
三是分析深度与客观性提升。 支持 300+ 维度自动分析,消除人工统计的主观偏差,数据精度更稳定。
四是门槛下降,情报民主化。 研发人员用自然语言就能检索,不必先成为检索专家,专利情报从"少数人的工具"变成"团队的公共能力"。
五是流程可追溯、可审计。 强制引用原文原句、标注出处与段号,配合标引、批注、评论与团队协作,形成可复核的工作留痕。
六、总结
需要清醒地看到三点边界:第一,AI 的漏检是"沉默的"——清单看着挺完整,人却不知道它漏在哪。解法是要求系统同时交出检索式与覆盖维度,不只看它给了什么,还看它覆盖了什么。第二,"摘不准"比"幻觉"更隐蔽——有出处、有原文,反而容易在人工复核时被放过,关键件必须回原文核对。第三,FTO 搜索不是最终法律意见,那永远需要专业 IP 律师出具;AI 提升的是清障分析的质量与速度,而非替代法律判断。
对企业和机构而言,落地建议遵循"高风险场景优先、先查后析":先把 FTO 与研发查新这类"漏检代价最高"的场景跑通,用真实项目验证召回质量,再逐步扩展到竞争监控、产业导航与运营决策。毕竟在知识产权领域,少漏一篇关键专利的价值,往往远大于多做十张漂亮的图表。