Hello,未来,「AI教育解决方案」重磅来袭!
详情
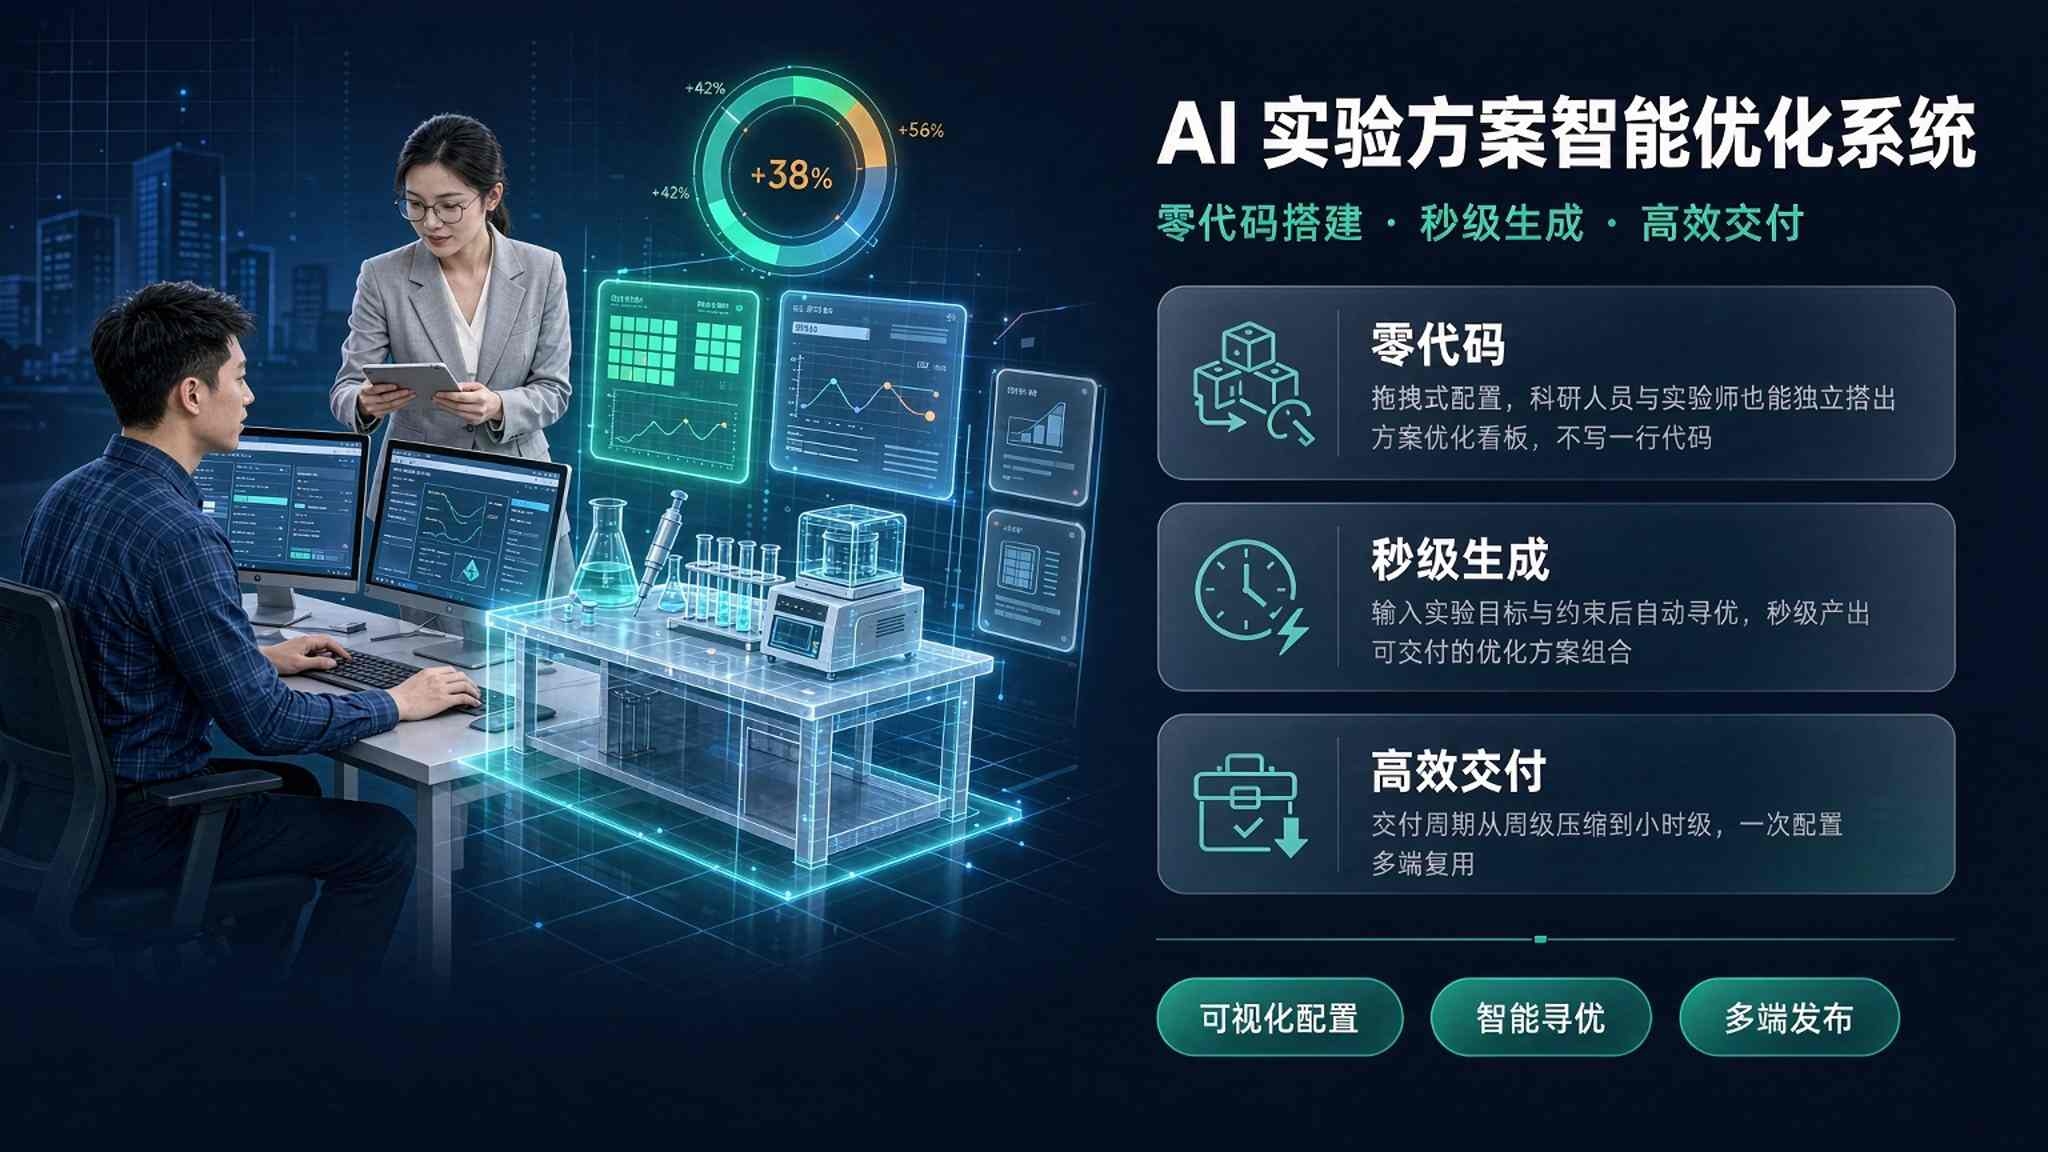
AI 实验方案智能优化系统:把"试错式科研"升级为"设计式科研"
一、AI 实验方案智能优化系统是什么
它是一套用人工智能驱动实验设计、参数寻优与方案迭代的研发中枢。系统整合文献、历史实验数据与领域知识,自动生成候选实验方案,用贝叶斯优化、主动学习等算法决定"下一组实验做哪几组",并在实验结果回流后自动更新模型、推荐下一轮方案,最终形成"设计—构建—测试—学习"(DBTL)的闭环。
它区别于传统实验设计(DOE)的关键在于:正交设计、响应面法是"先铺好一张网、再一网打尽";而 AI 系统是"边走边看"——每做完一轮实验就更新认知,把实验资源投向信息量最大或最可能出结果的区域,从而用远少的实验次数逼近全局最优。
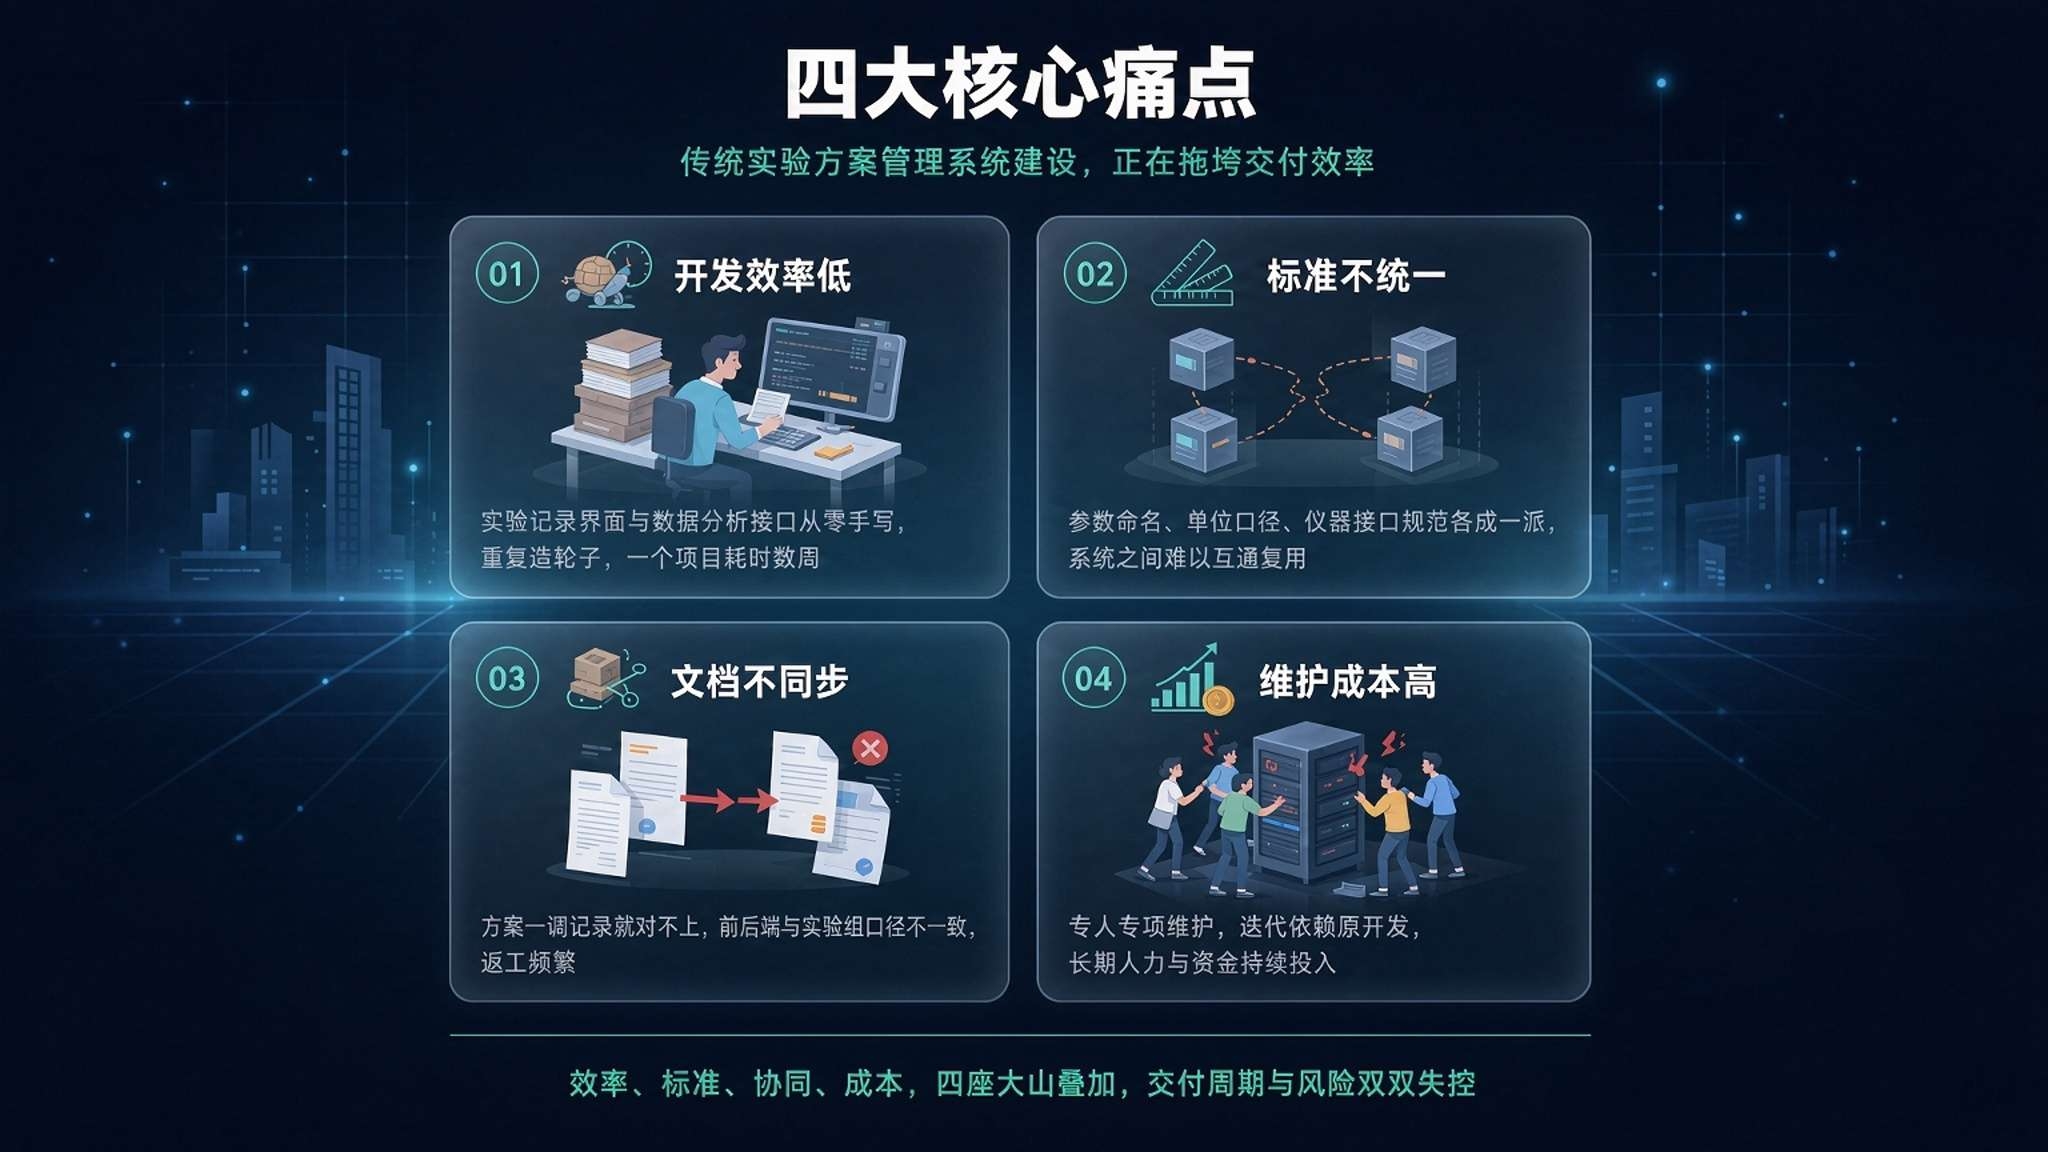
二、传统实验方案的五大核心痛点
实验次数呈指数爆炸。 一个含 8 个可调参数、每个参数三水平的配方,全因子设计需 6561 次运行,即便激进的部分析因也要 81~243 次;5 因子 3 水平的全因子就是 243 次。很多运行只是重复确认早先已提示的结论,但传统方法必须跑完整个矩阵。
时间大量耗在等待而非实验。 传统流程是"跑一批—等检测(常需 4~24 小时)—分析—设计下一批—再跑"。串行等待使 60%~70% 的调试日历时间花在等数据上。有工程师统计,Recipe 开发中 80% 的时间在跑实验等结果,只有 20% 在分析思考;一个收敛往往需要 5~10 轮循环。
高维非线性场景传统方法失效。 正交设计的有效性建立在"线性模型+低阶交互"假设之上。一旦存在强二阶、三阶交互(如催化剂浓度与温度的协同效应呈指数增长),正交设计会产生严重偏差,得到的"最优解"只是统计学幻觉。
经验锁在个人脑子里,无法传承。 工程师对某台设备的直觉——哪些参数会交互、甜蜜区在哪——通常只存在于个人头脑和零散笔记中。换一台同型号设备,调试基本从零开始。
保守收尾,性能被浪费。 因为调试昂贵又赶进度,工程师往往接受"够用"的工艺条件就转下一项。有研究指出,常规调试的设备通常运行在理论性能上限以下 5%~15%。
三、系统核心功能
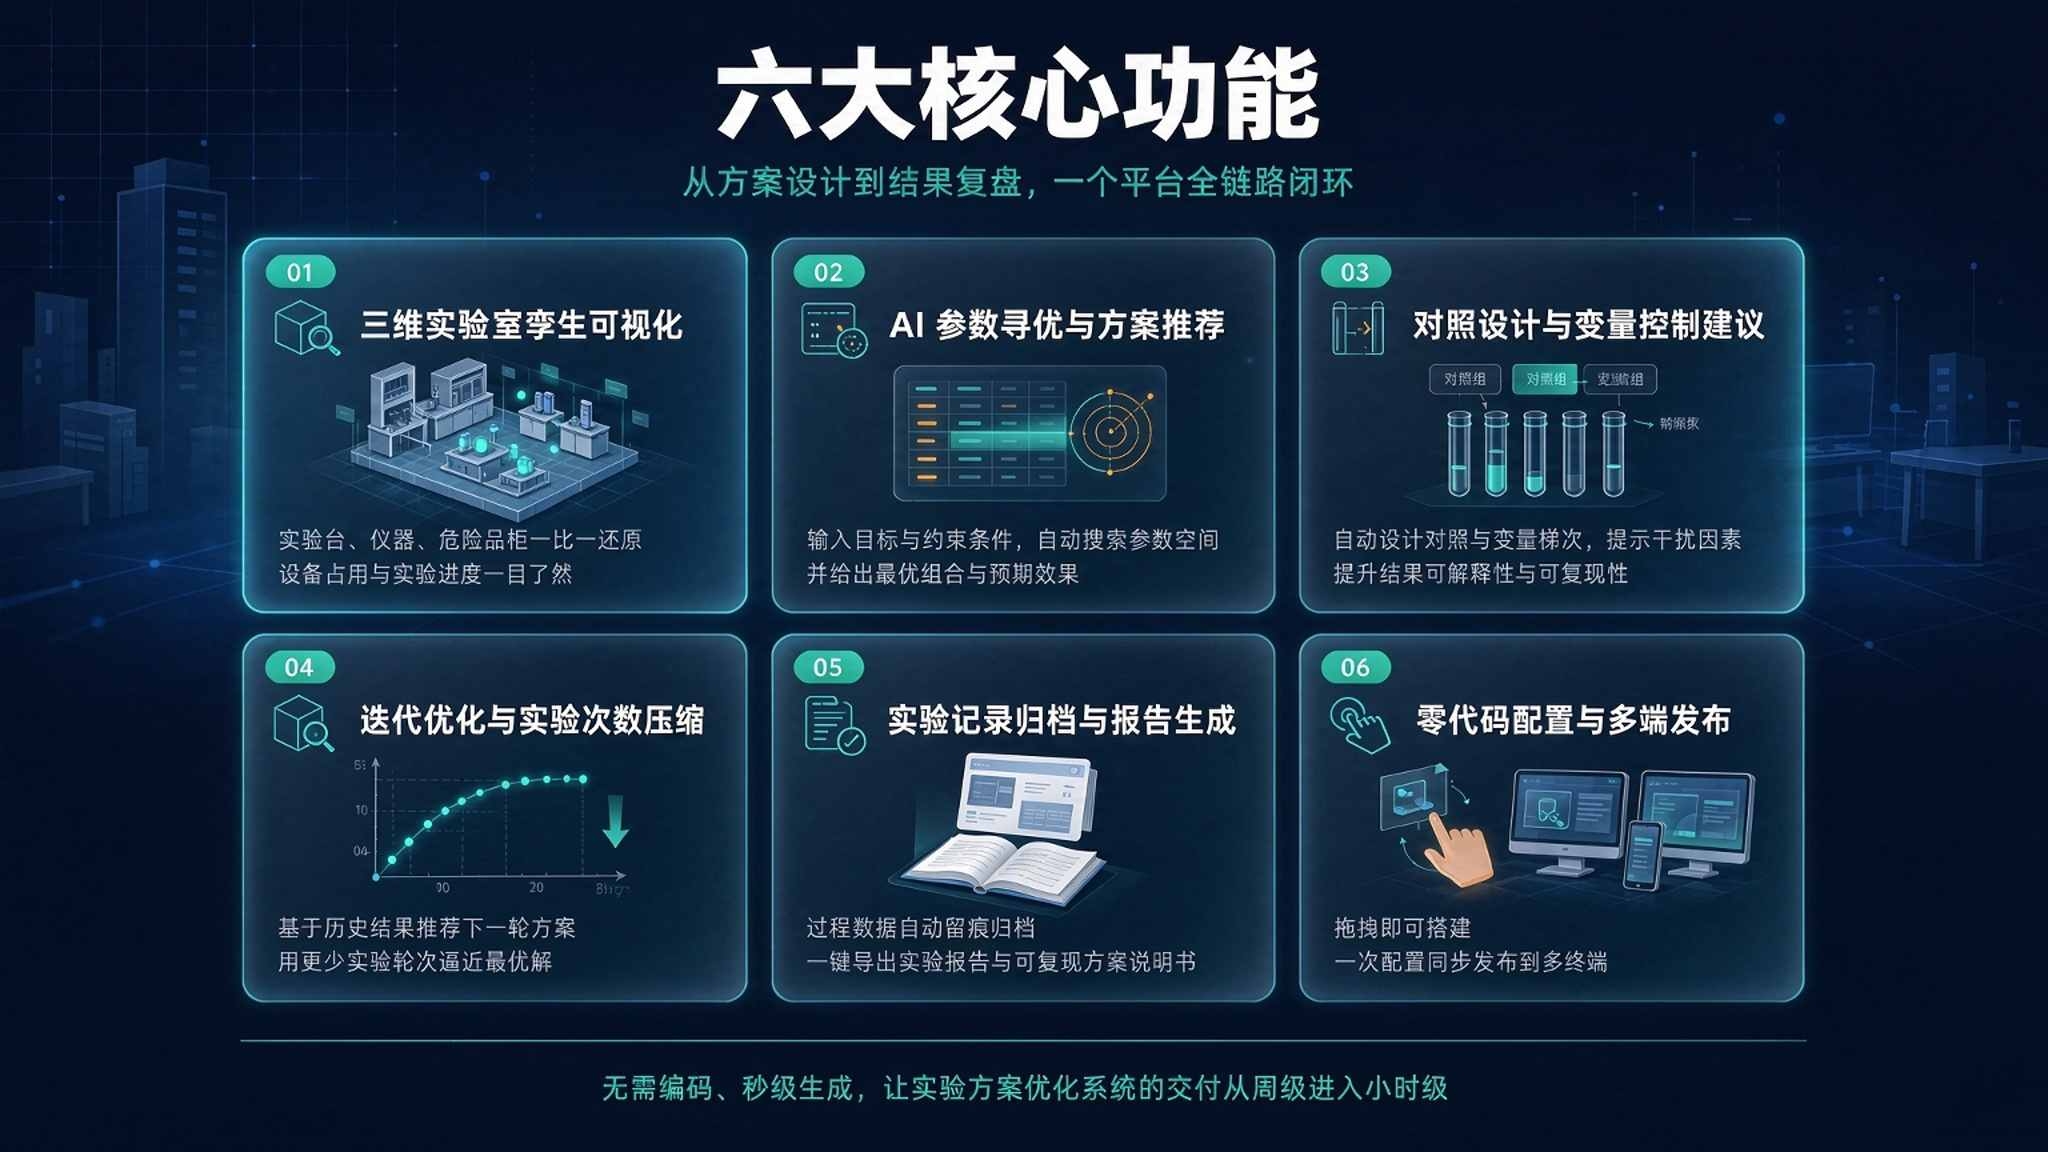
1. 文献与历史数据智能梳理。 自动研读文献、抽取候选因子与水平,把"做过但没记下来"的沉默数据转化为可用训练素材,生成因子—水平草案供人工核对。
2. 智能实验设计。 支持正交设计、均匀设计、拉丁超立方采样与响应面法,并可根据因子间的逻辑关系与约束条件(如配比总和为 100%、温度区间限制)生成合规的设计矩阵。
3. 贝叶斯优化与主动学习。 核心引擎:用已有数据拟合代理模型(高斯过程、随机森林、贝叶斯神经网络等),给出每个候选点的预测性能与不确定性,再由采集函数(EI、UCB 等)在"探索未知"与"利用已知好区"之间权衡,选出信息增益最大的下一组实验。
4. 多目标权衡与成本感知。 同时优化产率、纯度、成本、能耗等相互冲突的目标,自动给出帕累托前沿——例如"以略低产率换取显著降本"的方案会被识别为全局更优。
5. 虚拟实验与代理模型预筛。 用少量真实数据训练模型后,在模型上做大量"虚拟实验"快速筛选,再把最值得验证的少数组合送进真实实验。
6. 闭环执行与自适应迭代。 与自动化实验平台、LIMS、ELN 打通,实验数据回流后自动更新模型并推荐下一轮方案,无需等待整批完成。
7. 数据分析与可解释输出。 自动做因子重要性分析、响应面分析、多维关联图谱,输出可核验的实验记录与报告,满足 GMP/GLP 等合规审计要求。
四、典型应用场景
新材料与催化剂开发:在高维配比空间中寻优。中国科大机器化学家自主研读 16000 篇论文,融合 2 万组理论计算与 207 组实验数据,在 55 万种可能配比中锁定最优高熵催化剂方案。
药物 CMC 工艺与制剂配方:某小分子合成工艺仅用 3 轮(15 次)实验迭代即找到产率达 98.49% 的条件;某单抗多目标制剂优化以 33 次实验优于传统 DOE 的 60+ 次。
化工工艺与配方优化:青岛海洋化工研究院面对 1925 种理论组合的四元体系涂料配方,用智能实验设计仅 8 轮迭代、80 次实验锁定最优解,实验次数锐减 95%。
半导体工艺调试与设备验收:传统需 50 片测试晶圆的工艺,可压缩至 8~12 片;配方开发周期从 3~4 周缩短至 5~8 天。
食品、日化、化妆品配方:多原料比例 + 多工艺参数(pH、温度、时间、流速)的协同寻优。
自主实验室与高通量平台:配合机器人实现无人值守运行。人工单日仅能完成一组实验,机器一夜可完成上百组;清华化学系自动化平台较人力效率提升 10~30 倍。
五、五大核心优势
一是实验次数锐减。 贝叶斯优化在高维、非凸、非线性、黑箱场景下,实验次数通常比传统 DOE 节省 30%~60%,极端场景可达 90% 以上;部分案例以不到全因子 10% 的工作量逼近最优解。
二是周期大幅压缩。 从"跑完整个矩阵"变为"自适应迭代",配合并行学习消除分析瓶颈,整体时间压缩 60%~75%。中国科大"灵境造物"平台上,跨学科团队仅用三周就研发出相变智冷背心并交付使用。
三是结果反而更优。 贝叶斯优化能探索传统设计覆盖不到的非直觉区域,常找到比人工调试更好的最优解,避免陷入局部最优。
四是知识沉淀可复用。 每次优化都生成结构化过程模型并版本化存储。下一台同型设备调试时从既有模型出发微调,而非从零开始。
五是门槛下降、经验民主化。 研发人员不必先成为统计学专家,用自然语言描述目标与约束,系统即可生成可核验的设计矩阵。
六、总结
需要清醒地认识到四条边界:第一,先有经典设计,再让 AI 优化——正交表、部分析因、响应面这些有数学保证的方法是骨架,AI 的角色是填补探索空间与加速收敛。第二,警惕分布外陷阱——采集函数倾向在模型不确定处取样,容易忽略边界工况,需在设计中强制加入角落点与中心点。第三,防范数据泄漏——训练集与测试集若来自同批次设备漂移,评估指标会虚高,应按时间或设备分块切分。第四,关键产物必须人工复核——即便登上顶刊的自主实验结果也可能存在表征误判。
此外,历史数据中的参数变化通常不是正交的,因子互相纠缠,直接套传统分析会得出误导性结论,需要更严格的因果推断来分清"相关"与"因果"。
对研发机构而言,落地建议采取"并行验证、分步推广":先选一个已有充分认知的工艺,让 AI 方案与传统 DOE 并行跑一遍做对照,用真实数据建立本组织的基准,再逐步扩展到设备验收、配方开发与新材料探索。毕竟,研发最贵的从来不是仪器,而是那些本可以避免的、重复而盲目的实验。