Hello,未来,「AI教育解决方案」重磅来袭!
详情
全链路可观测性平台:链路统一观测与性能定位解决方案
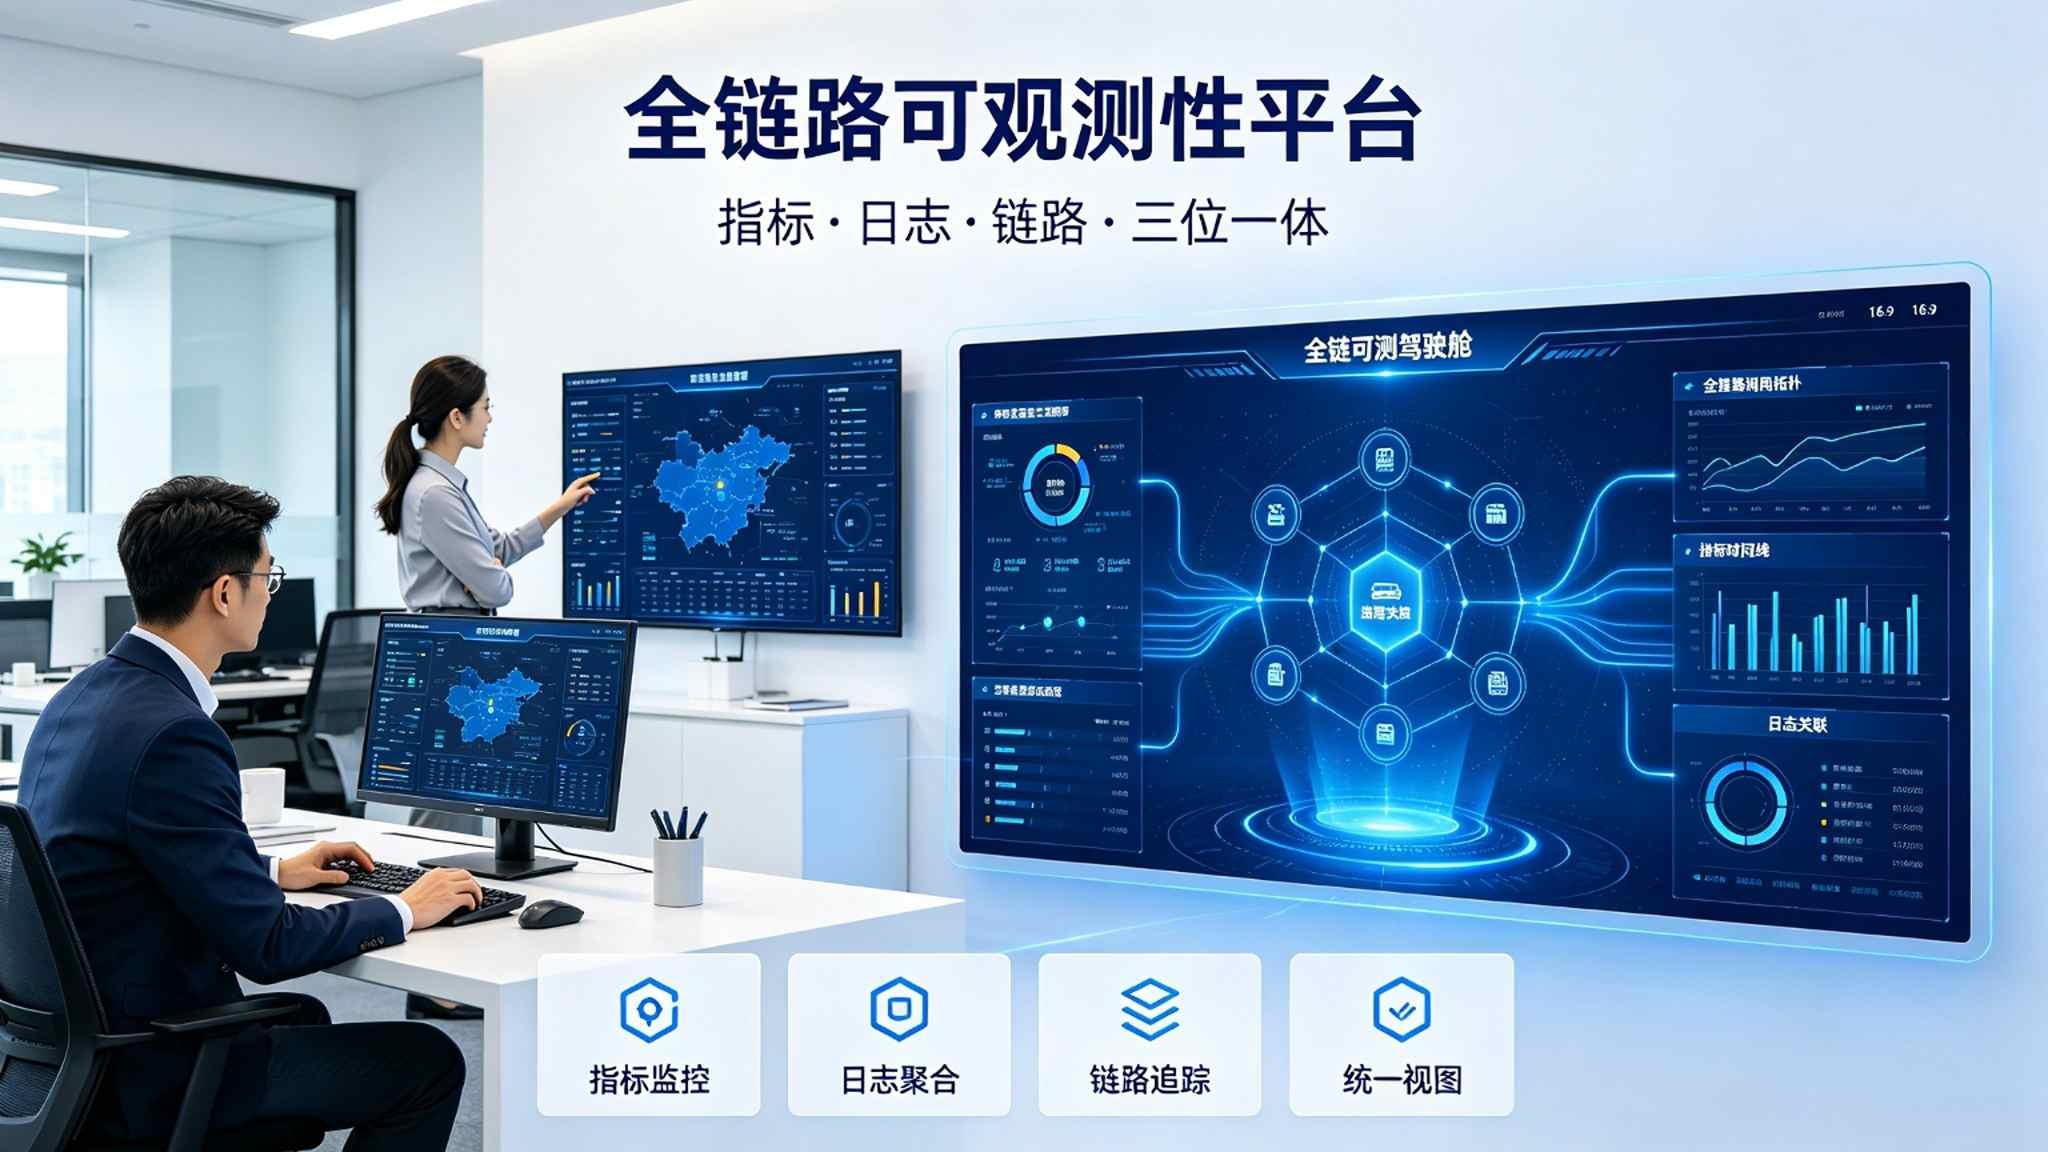
微服务和分布式系统上线后,一个用户请求会经过十几个服务。一旦页面变慢、报错,运维和开发往往要先看监控指标、再翻日志、再猜是哪个服务慢,三个系统来回切,问题迟迟定位不到。传统监控只能告诉你"哪不对",却答不上来"为什么不对、卡在哪一跳"。全链路可观测性平台把指标、日志、链路追踪三类信号打通,一次请求从入口到数据库的每一步耗时、错误都能串起来看清,让故障和性能问题从"盲人摸象"变成"一目了然"。
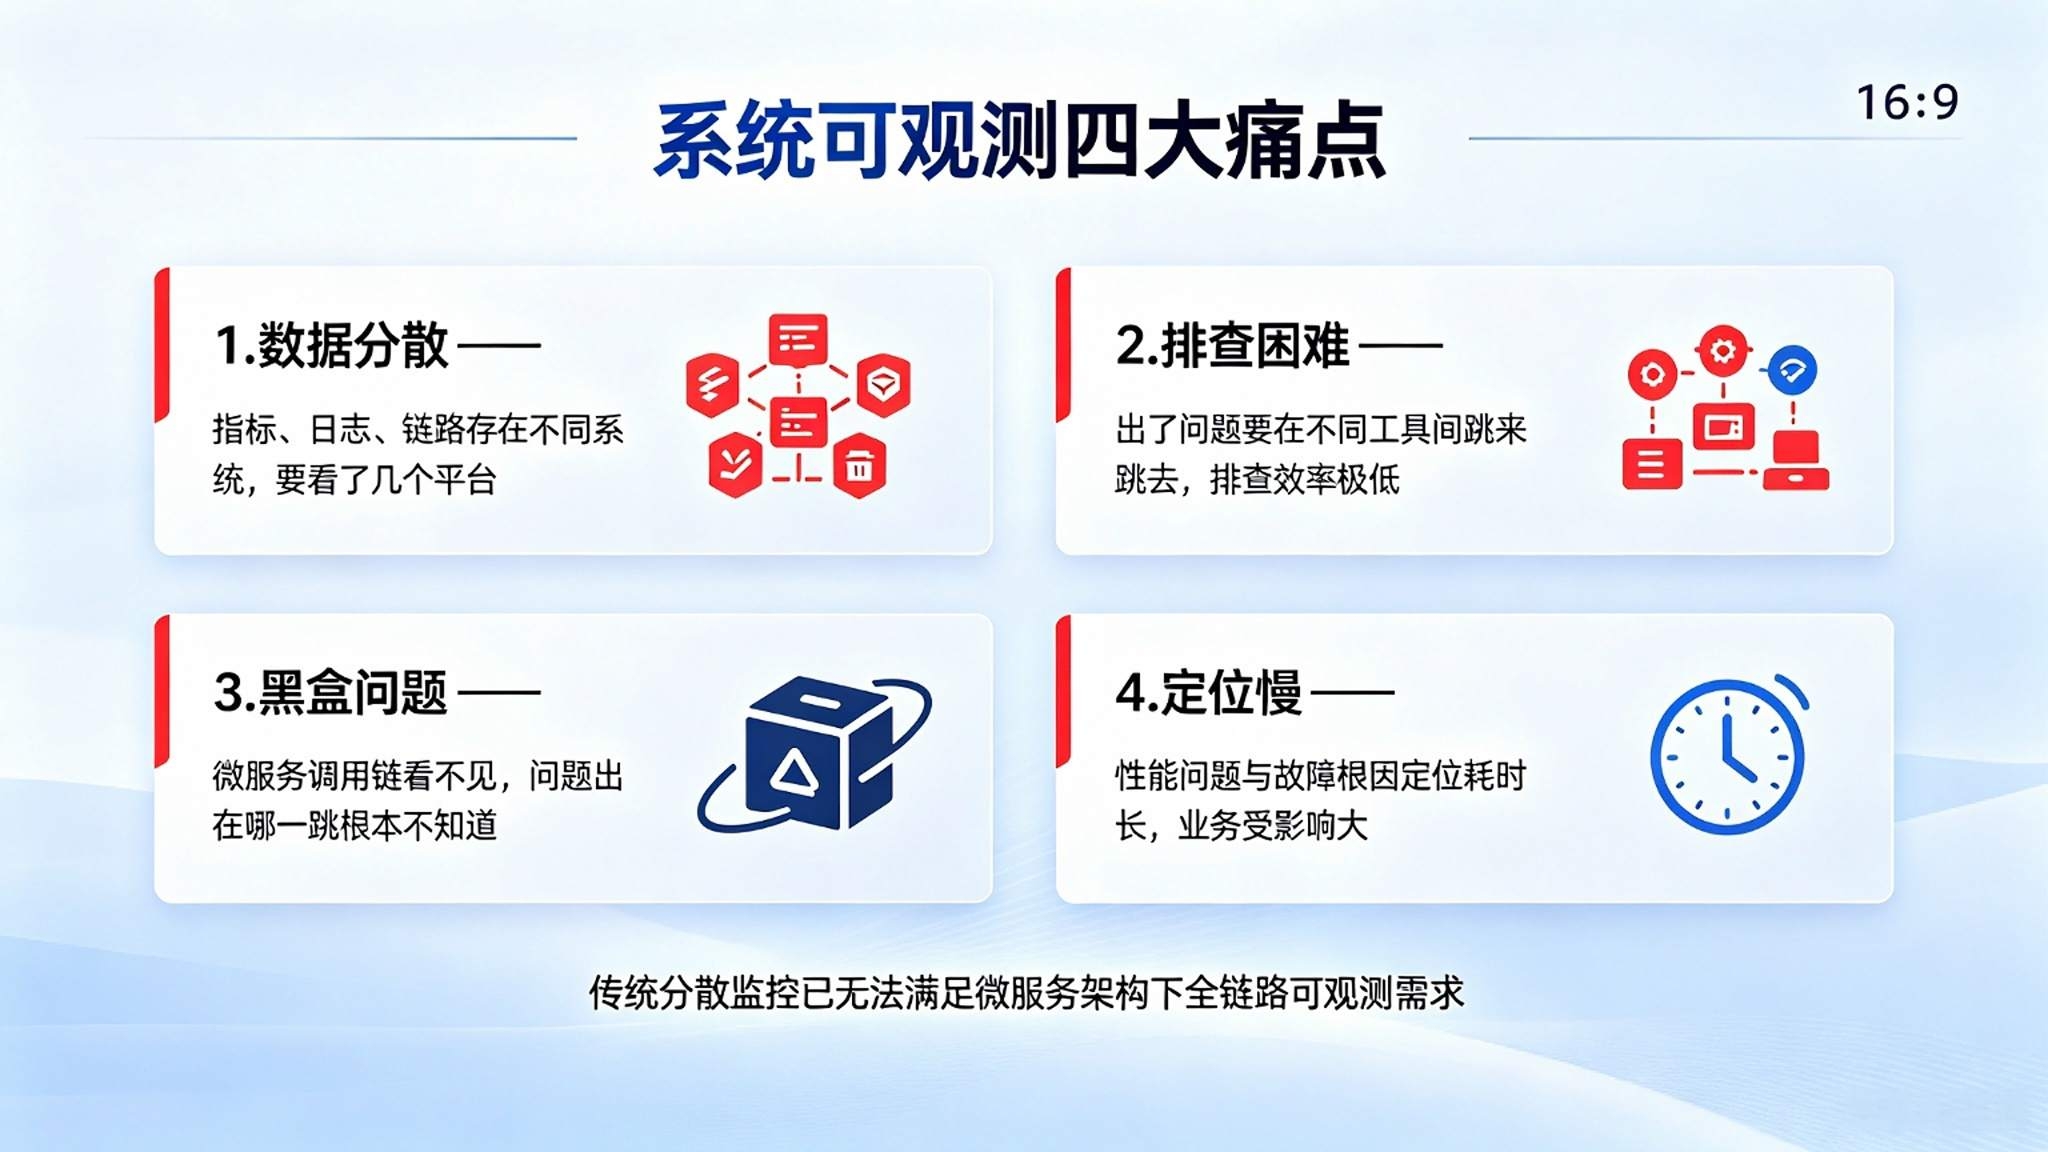
一、传统监控的核心痛点
1. 三类数据各自孤立。监控看指标、日志在另一套系统、链路又在别处,发现异常要反复切换,关联困难。
2. 看不到请求全貌。一个请求跨多个服务,只知道整体变慢,不知道慢在哪个服务、哪一跳、哪次调用。
3. 性能瓶颈难定位。哪个接口慢、哪条SQL耗时长、哪次外部调用拖后腿,缺乏端到端视角,只能靠猜和试。
4. 故障排查慢。报错了要在海量日志里搜关键字、在监控里找异常,时间花在找数据上而不是解决问题。
5. 影响范围看不清。某个服务出问题会影响哪些接口、多少用户,缺乏调用关系视角,评估影响不直观。
二、全链路可观测性平台核心功能
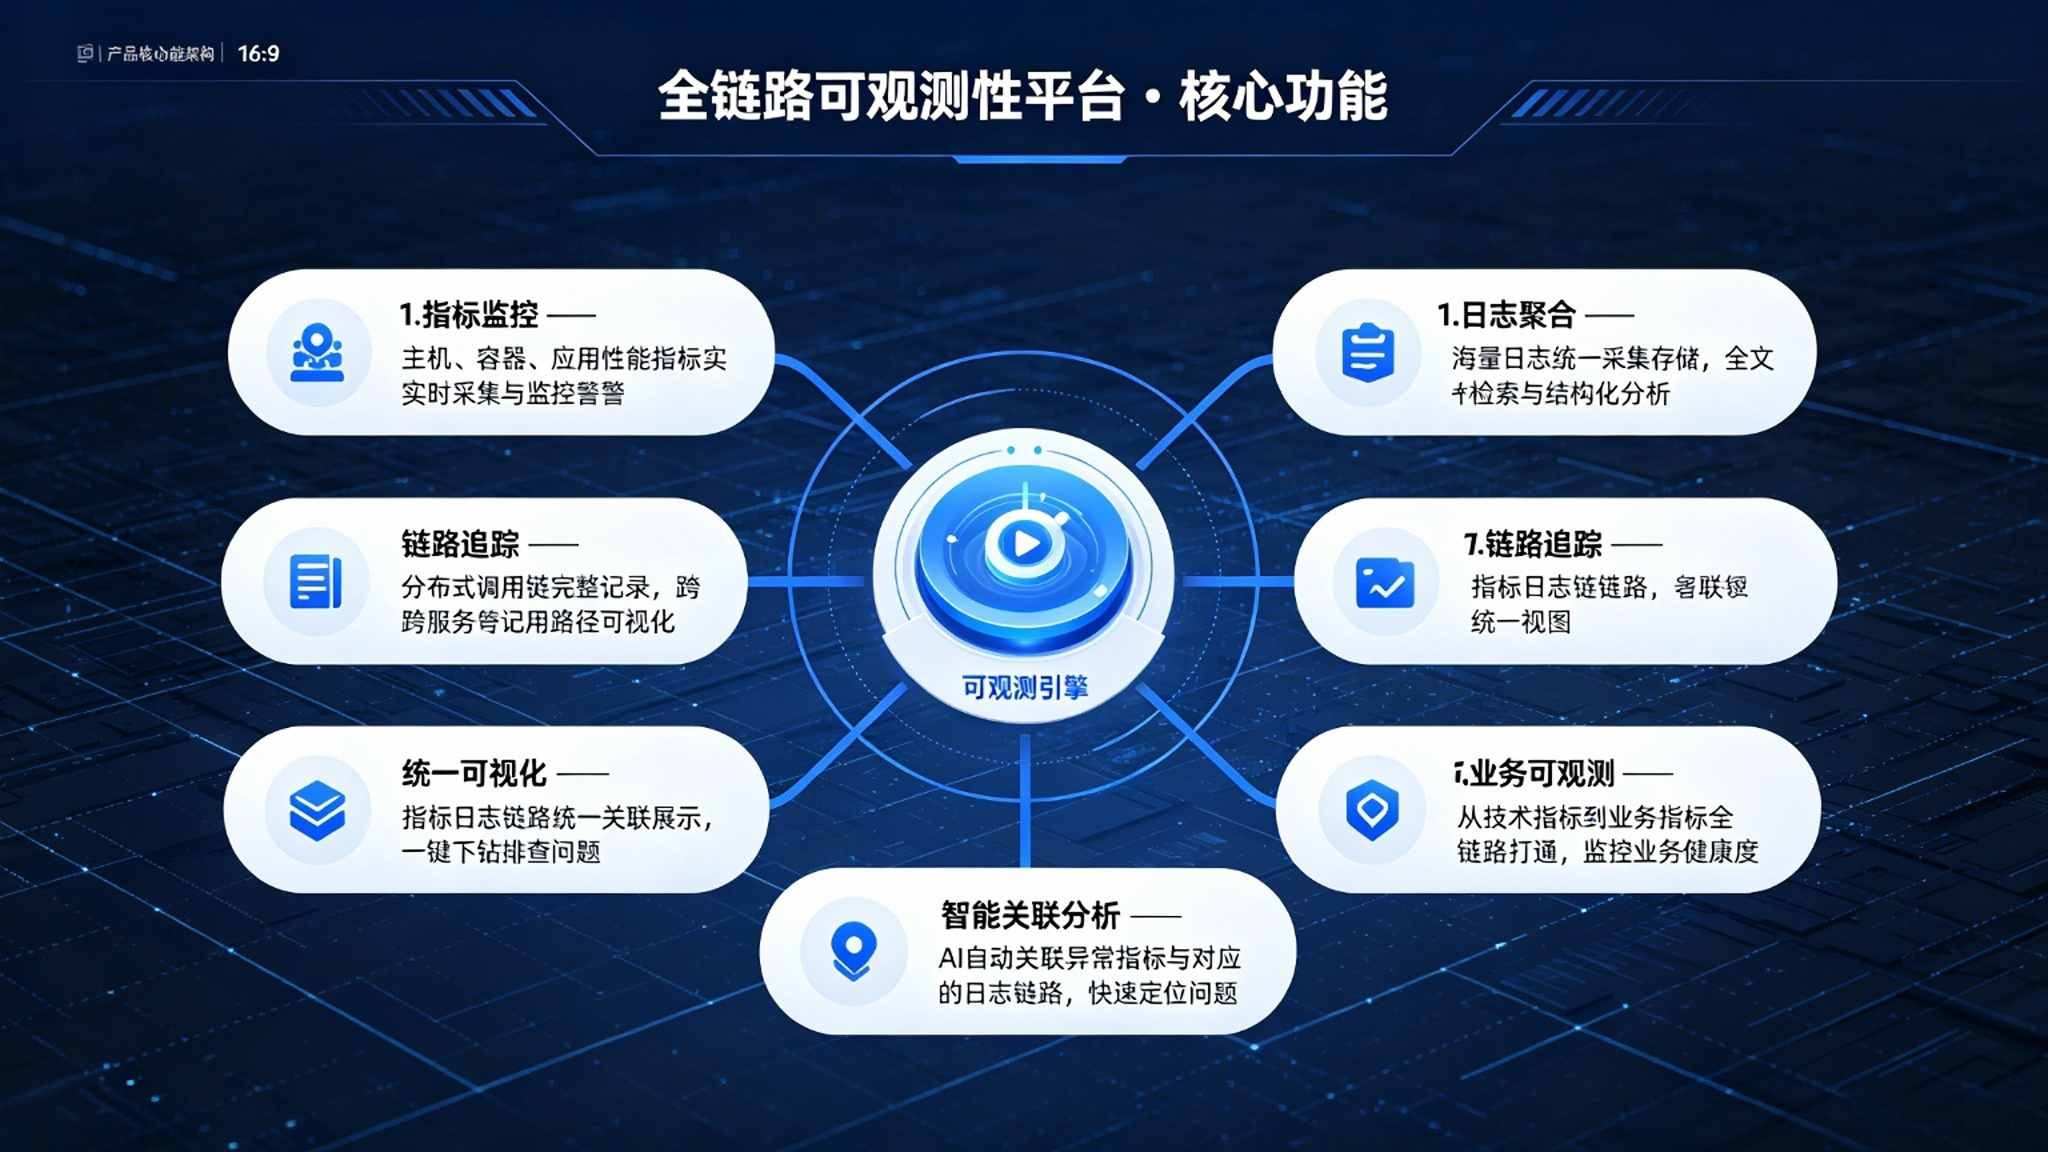
1. 指标监控(Metrics)
统一采集服务、接口、主机的吞吐、延迟、错误率等指标,以图表展示趋势,快速发现整体异常。
2. 日志聚合(Logging)
集中采集各服务日志,支持按服务、时间、关键字检索;日志与请求关联,定位到具体一次调用的细节。
3. 全链路追踪(Tracing)
为每个请求分配唯一追踪ID,完整记录经过的每一个服务、每一次调用及耗时,慢在哪一跳一目了然。
4. 服务拓扑自动发现
根据调用关系自动生成服务依赖拓扑图,哪个服务调用了谁、依赖健康状况如何,可视化呈现。
5. 三信号关联分析
从一个异常指标一键下钻到对应的链路和日志,把指标、链路、日志串在同一上下文,秒级定位根因。
6. 告警与可视化大屏
基于错误率、延迟等异常自动告警;大屏展示服务健康、慢接口和错误TOP排行,支撑日常运维。
三、建设实施路径
1. 数据埋点接入。为应用接入探针,开启指标、日志和链路数据上报。
2. 平台部署。部署可观测性平台,配置数据存储和保留策略。
3. 关联打通。通过Trace ID把三类数据关联,验证一次请求的完整链路可串起。
4. 告警与看板配置。为关键服务和接口配置告警与监控看板。
5. 推广使用。让开发和运维用平台排查问题,持续优化覆盖范围。
四、方案总结
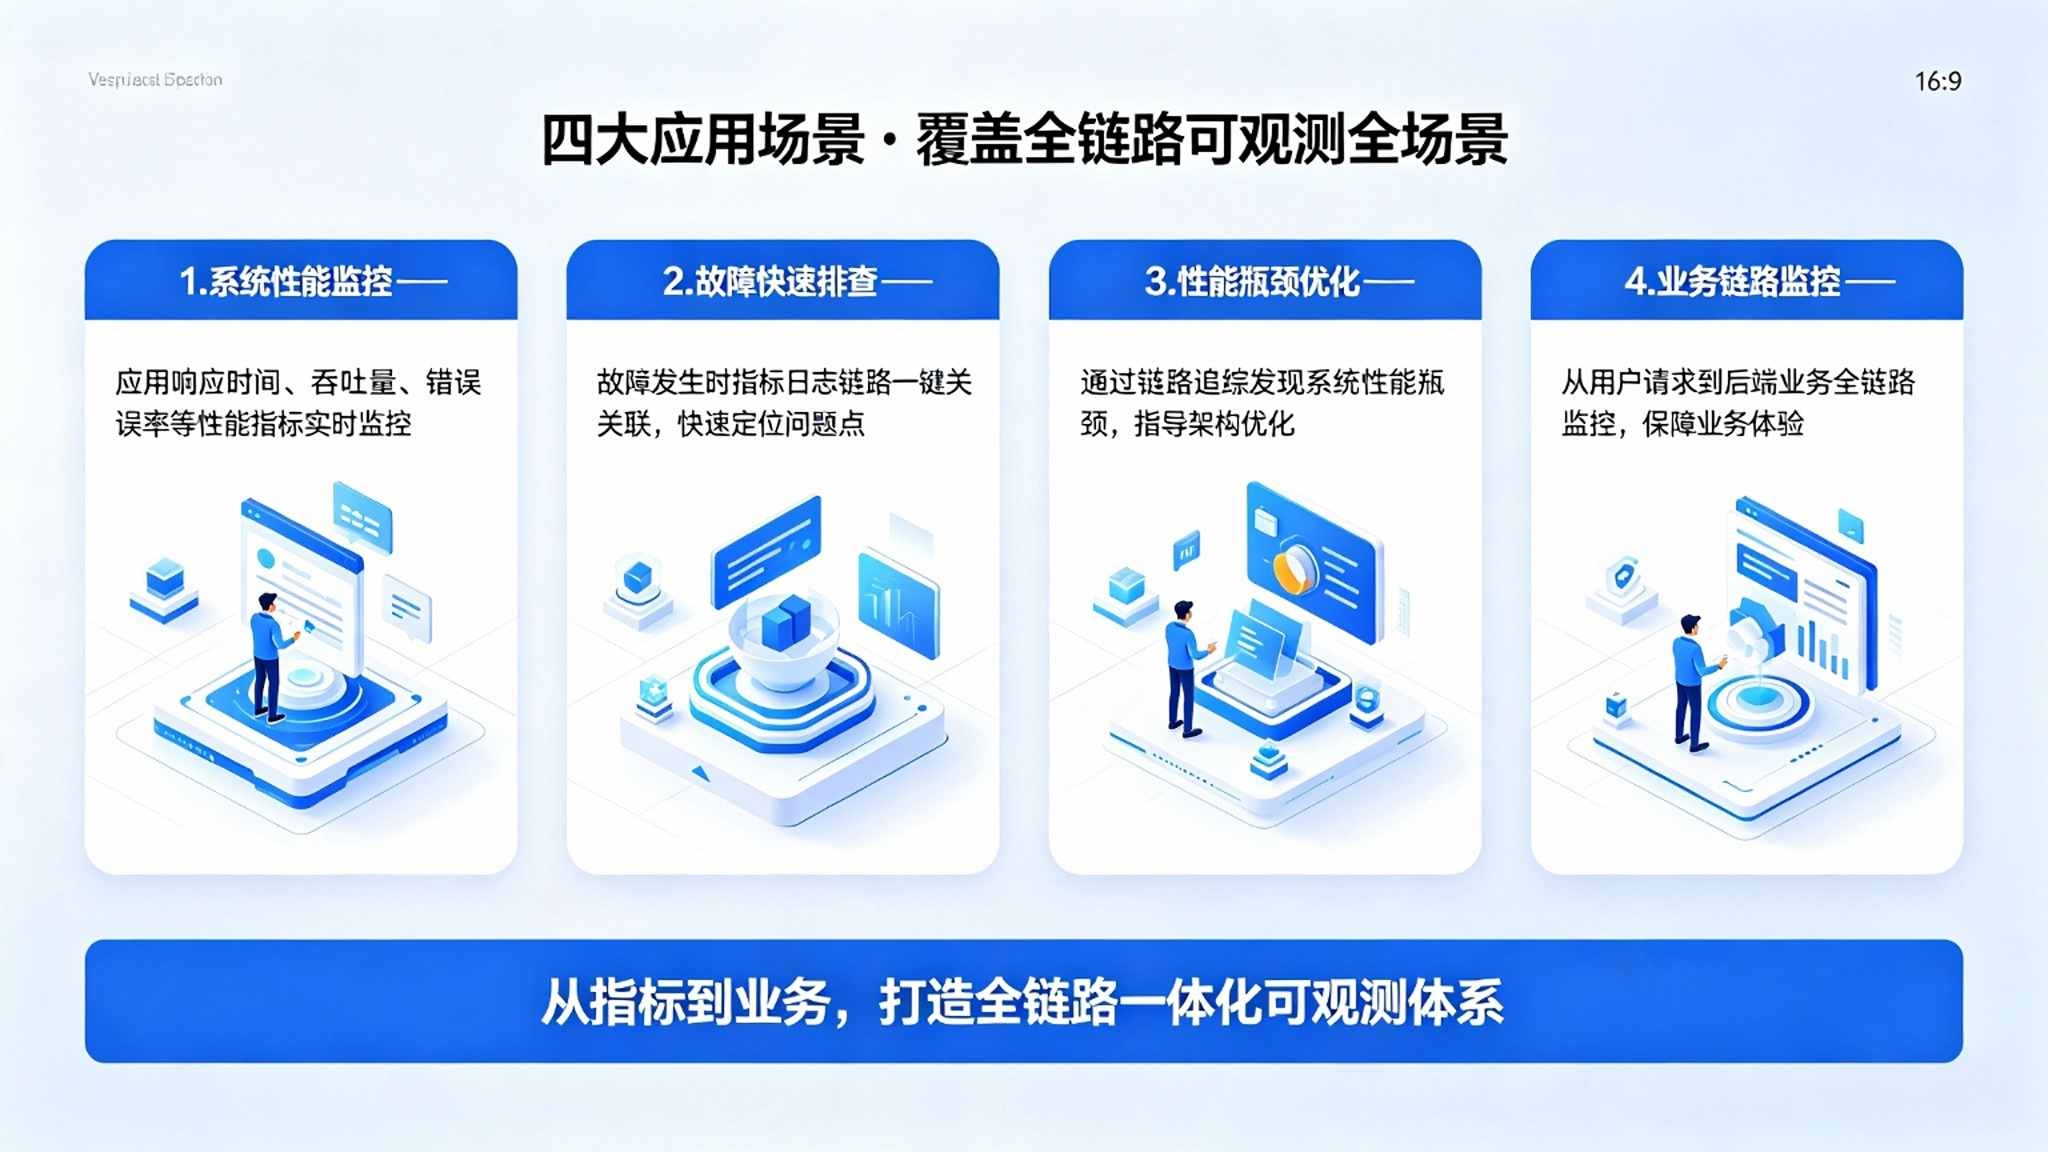
全链路可观测性平台通过指标监控、日志聚合、全链路追踪、服务拓扑、三信号关联、告警大屏六大能力,把监控从"只知其然"升级为"知其所以然"。它推动数据视角从"三类孤立"向"统一关联"转变、问题定位从"跨系统翻找"向"一键下钻"转变、性能分析从"猜瓶颈"向"看每一跳耗时"转变、影响评估从"不直观"向"拓扑可视"转变。在微服务架构日益普遍的背景下,这套平台将显著缩短故障和性能问题的排查时间,让系统运行状态看得见、问题找得到、原因说得清。